从检索策略到论文研读:用 Codex 与 Undermind 搭建科研文献工作流(上)
从检索策略到论文研读:用 Codex 与 Undermind 搭建科研文献工作流(上)
“工欲善其事,必先利其器。”在正式进入硕士阶段之前,我想先把科研中最容易混乱、也最值得规范的一段流程跑通:如何从一个模糊的研究兴趣出发,形成可检索的问题,找到真实论文,并判断它们究竟能否回答当前问题。
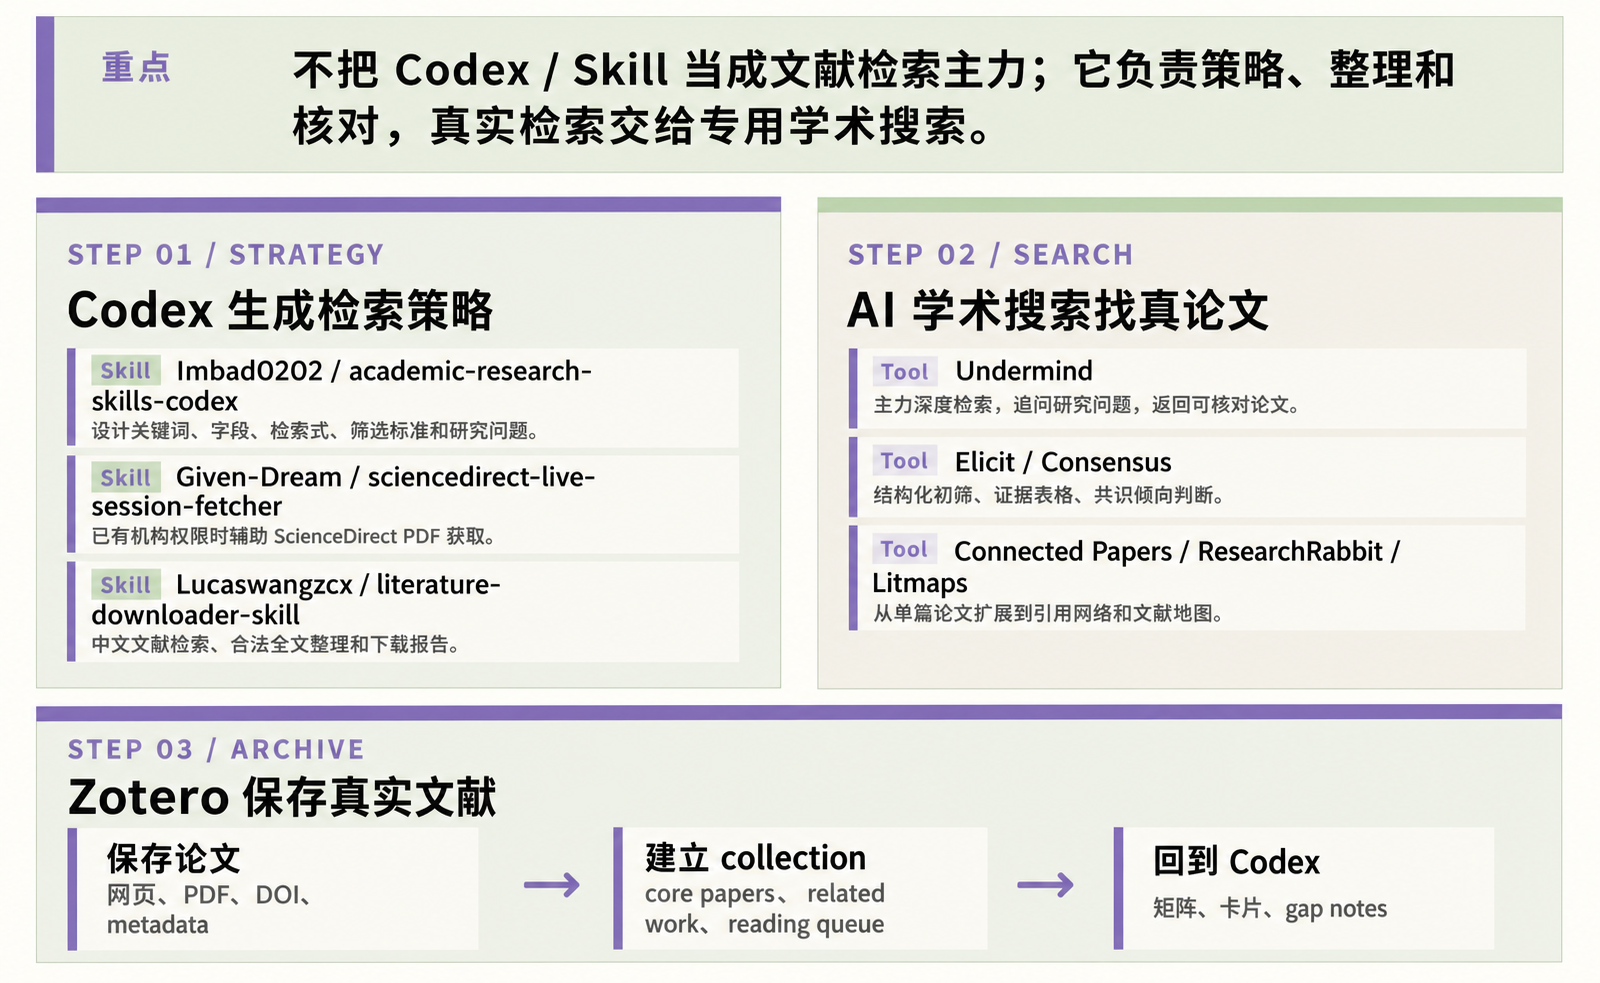
这次没有追求一次装齐所有热门 AI 学术工具,而是先验证一个最小组合:
Codex 制定检索策略与核验边界 → Undermind 搜索真实论文 → AI 辅助研读与归纳。
在真正动手之前,我先让 Codex 将整个设想拆成分阶段计划:从测试题设定、检索策略、主检索和结构化筛选,一直延伸到全文获取、Zotero 归档、深度研读与成文。当天并不要求完成所有阶段,而是先跑通其中最小、最有价值的一段。
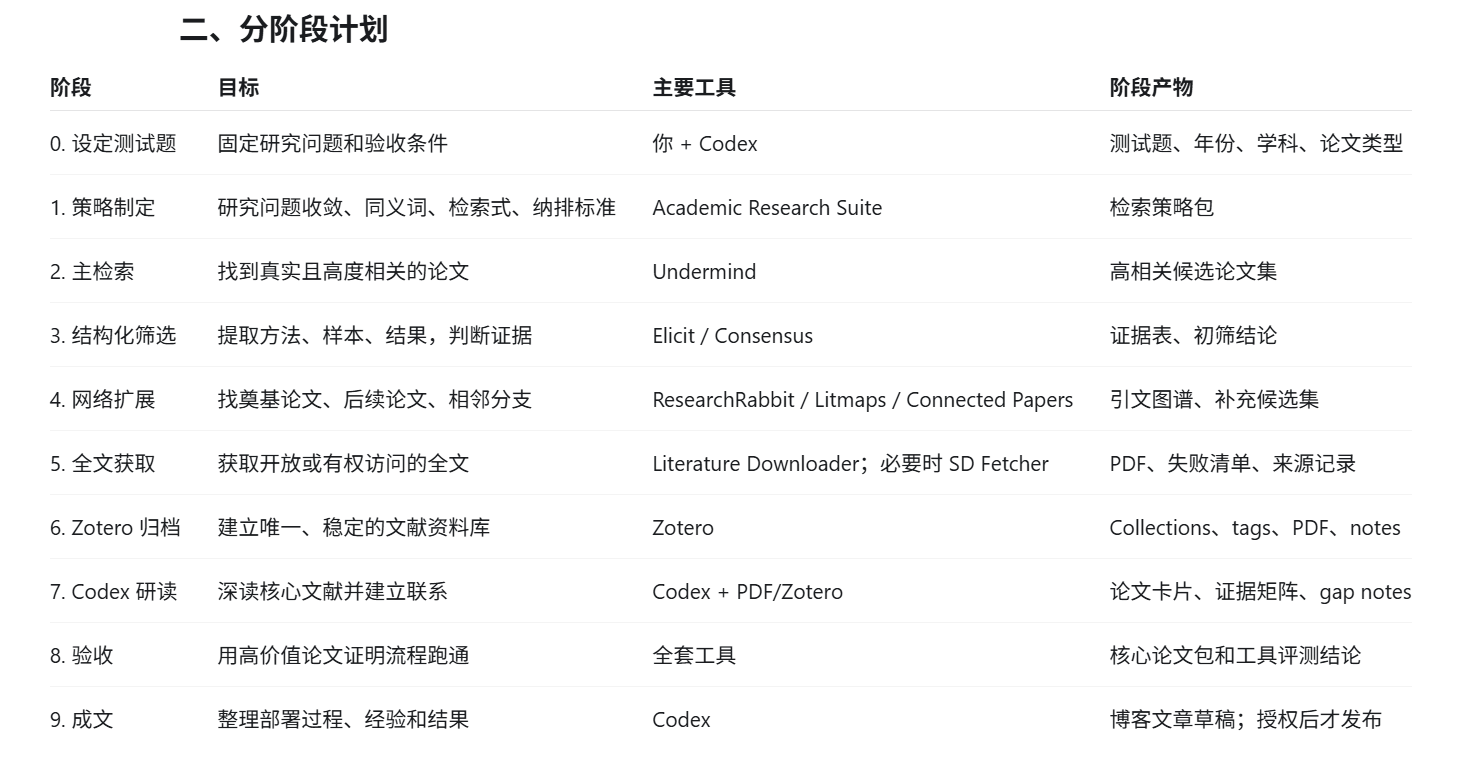
图 1:Codex 对完整科研文献流程的阶段划分。本文实际完成的是题设收敛、策略制定、主检索、初步研读和书目归档。
Elicit、Consensus、ResearchRabbit 和 Litmaps 暂时留到下一阶段。本文记录第一天已经跑通的部分,以及第一次真实检索带来的阶段性认识。
一、先划清边界:Codex 不应该充当论文数据库
我最初的流程图里有一条很重要的原则:不要把 Codex 或某个 skill 当成文献检索的主力。大语言模型更适合:
- 把宽泛主题拆成研究问题;
- 设计关键词、筛选标准和证据矩阵;
- 阅读、比较和质疑论文;
- 检查 DOI、元数据、方法与结论是否一致;
- 整理论文卡片和研究缺口。
真正负责从学术语料中检索论文的工作,应交给 Undermind、Elicit、Consensus 或传统学术数据库。这样的分工可以降低“引用看起来很真实,实际上却不存在或并不支持当前论点”的风险。
二、真实测试主题:机器学习 × 遥感影像
为了避免只做一个没有科研价值的工具演示,我使用了一个经过脱敏的真实场景:某地区裸地实际覆盖面积监测。
当前约束是:
- 最终需要统计某个行政区或样区的裸地总面积;
- 输入数据约为 5 m 空间分辨率的卫星图像;
- 只有 RGB 三个可见光波段;
- 目前主要工作是人工打标签;
- 裸地定义主要依靠面对面示范和主观判断,尚未形成书面操作规范。
最初关注的“地物分类、语义分割、目标检测”并不都同等适用。由于最终产物是面积,而不是目标的位置和数量,目标检测暂时退出主线;更可能的路线是用分类或语义分割生成裸地分布图,再进行面积统计。
这里也暴露出一个基础问题:现有标签不能自动等同于稳定的 ground truth。裸地和稀疏植被的边界如何定义、不同标注者是否一致,都可能直接影响最终面积。
三、让 Codex 负责检索策略
本次使用 Academic Research Suite 辅助收敛问题。它并不提供论文数据库,而是帮助把研究对象、数据条件、目标产物和证据要求写成可检索的任务。
经过梳理,本轮检索被限定为:约 5 m RGB 卫星影像、某地区裸地识别、行政区或样区面积统计,并同时关注分类与语义分割、标签不确定性、跨区域泛化和计算成本。由于当天主线是验证工具流程,裸地的操作性定义暂时保留为后续问题。
四、接入 Undermind:操作引导与效果
Undermind 可以通过远程 MCP 接入 Codex。完成网页端登录后,可在终端执行:
codex mcp add undermind --url https://mcp.undermind.ai/mcp --oauth-client-id codex
codex mcp login undermind
第一条命令有时会自动进入 OAuth 授权,此时不必重复登录。完成授权后重启 Codex Desktop,新任务中即可调用 Undermind 的学术搜索、论文元数据、引文扩展和 PDF 阅读能力。
实际效果是:检索目标可以直接从 Codex 提交到 Undermind,搜索结果和可用全文也能返回当前研究流程,省去了在多个工具间反复复制查询和论文信息的步骤。
五、第一次真实深度检索:结果与评价
第一次检索没有只提交若干关键词,而是给出一个自包含研究目标:寻找适用于约 5 m、RGB-only 卫星影像的裸地分类或语义分割研究,并重点检查少量或主观标签、跨区域迁移、计算成本,以及像素级精度能否支持可靠的面积统计。
检索名称为“5m RGB裸地面积估算”,约两分钟完成。首轮结果如下:
| 项目 | 结果 |
|---|---|
| 候选论文 | 35 篇 |
| 达到高相关阈值 | 5 篇 |
| 当时可由 Undermind 直接读取 PDF | 2 篇 |
| 主要覆盖主题 | 裸地制图、少样本学习、跨区域泛化、面积估计、标签不确定性 |
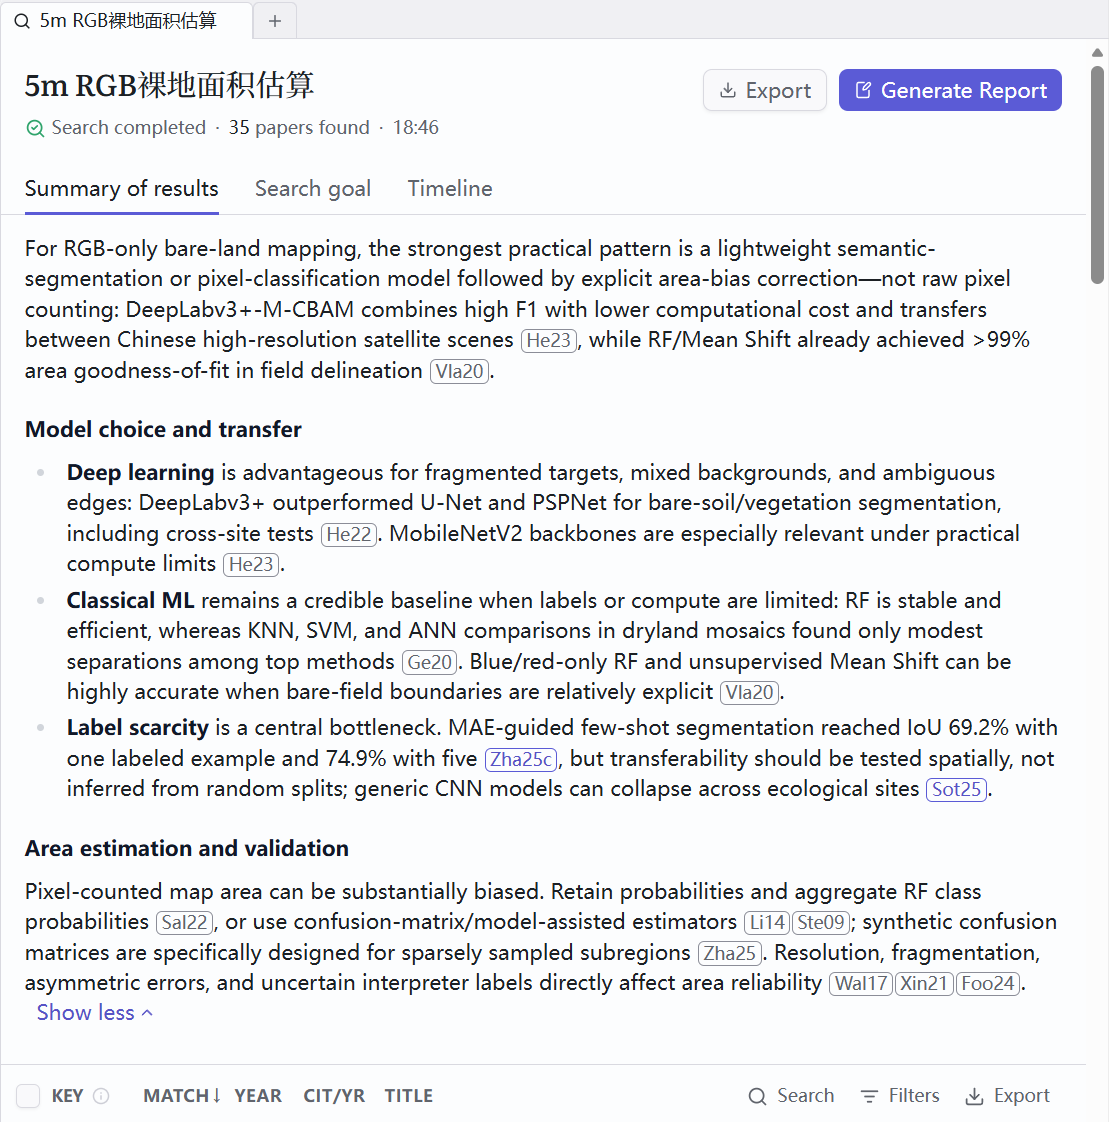
图 2:Undermind 的首轮检索概览。它不仅汇总模型选择,也主动提示了跨区域泛化、标签稀缺和面积偏差等问题。自动总结适合建立全局认识,但仍需回到论文原文核验。
结果可在 Undermind 工作区中查看。代表性结果包括:
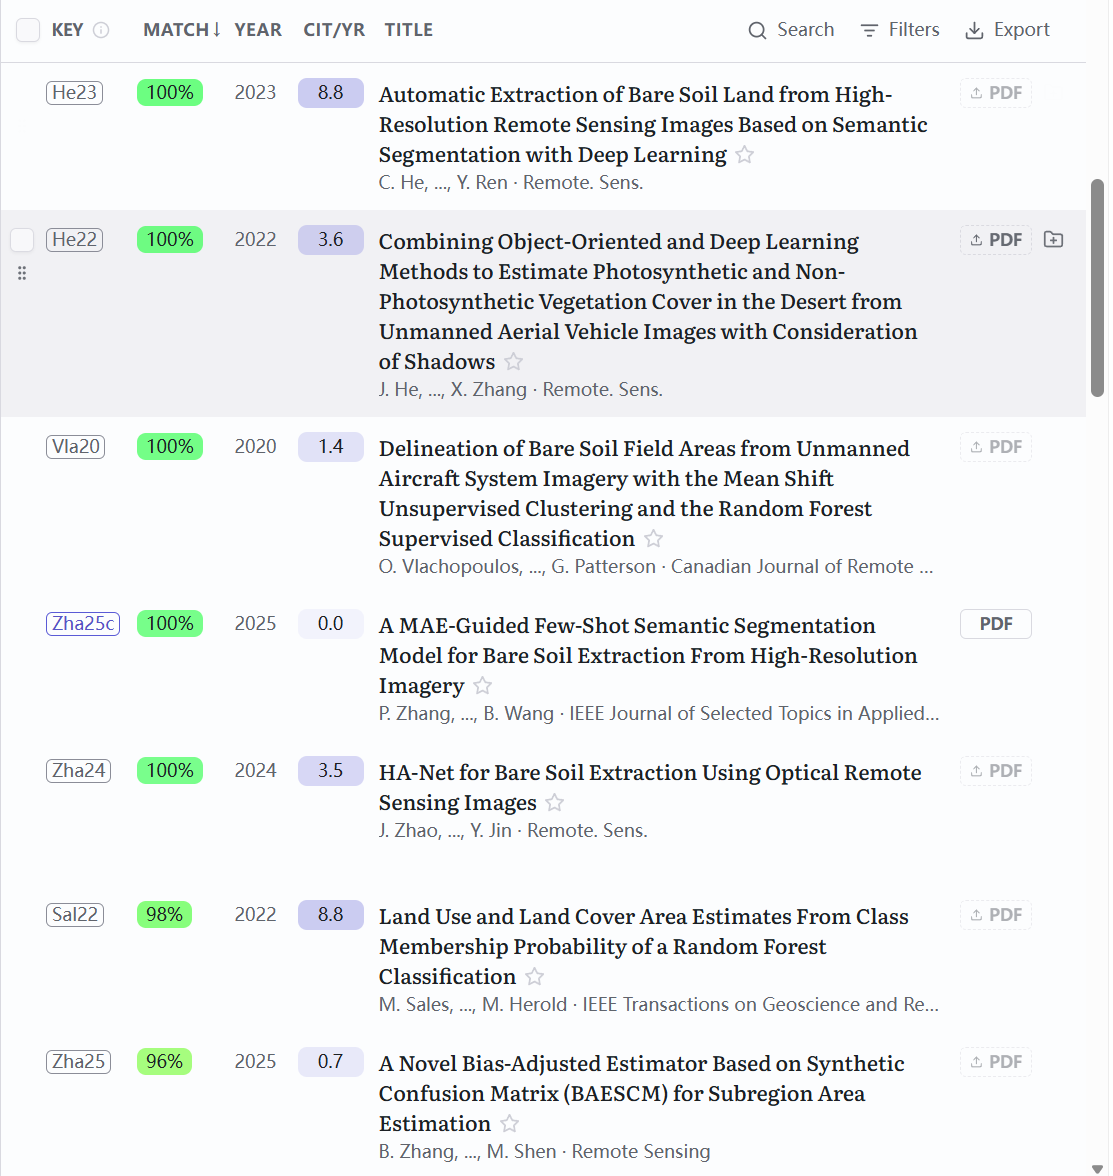
图 3:首轮候选论文列表。界面中的匹配率表示论文与检索目标的语义相关程度,并不等同于论文质量、证据强度或对当前数据条件的直接适用性。
| 论文 | 首轮价值 | 适用性限制 |
|---|---|---|
| He 等(2023) | 使用轻量化 DeepLabv3+ 提取裸地,并涉及迁移测试 | 城市裸地、0.8 m 影像,与当前 5 m 场景存在域差异 |
| Zhang 等(2025) | 探索少样本裸地语义分割 | 仍使用约 5 万个未标注样本和长时间预训练,不能简单理解为低成本 |
| Vlachopoulos 等(2020) | 说明 Random Forest 等传统方法仍可作为可靠基线 | 数据来自高分辨率 UAV,不能直接代表 5 m 混合像元 |
| Sales 等(2022) | 将类别概率用于面积估计,连接“制图”与“统计面积” | 不是针对当前裸地场景,需要后续验证 |
| Waldner 与 Defourny(2017) | 讨论分辨率和景观破碎度对面积偏差的影响 | 属于面积估计方法证据,而不是具体裸地模型 |
| Stehman 等(2022) | 量化参考标签判读者差异对面积不确定性的影响 | 需要转化为适合当前标注流程的实验设计 |
这次检索的优点是,它没有把结果限制在“哪个模型精度最高”,而是同时找到了制图、面积估计和标签不确定性三类证据,并返回了可核验的 DOI 和论文元数据。
局限也很明显:严格同时满足“5 m、RGB-only、卫星影像、裸地、区域面积统计”的论文很少,部分候选使用 0.8 m 影像、UAV 或多光谱数据;35 篇中当时只有 2 篇能自动读取全文。因此,Undermind 适合扩大候选池和发现相邻方法,但相关度排序不能替代人工核验,摘要也不能替代论文正文。
六、第一次检索的 AI 简要总结
以下内容是 AI 基于首轮结果和当时可核验全文形成的阶段性概览,不是论文结论的简单拼接,也不是已经确定的研究方案。
- 模型层面:语义分割更适合表达复杂边界,但 Random Forest 等传统方法仍值得作为低成本基线。少样本方法可以减少人工标签,却未必减少未标注数据、训练时间或算力需求。
- 面积层面:IoU、F1 等地图精度指标不能直接保证总面积准确。硬分类后的像素计数可能产生系统偏差,类别概率汇总、误差矩阵校正或抽样辅助估计值得单独比较。
- 数据层面:主观标签、分辨率造成的混合像元,以及跨地区迁移失败,都可能比模型结构的小幅改进更影响最终结果。
这次检索最重要的作用,是把一个笼统的“用机器学习识别裸地”问题,初步拆成了制图质量、面积可靠性和标签可信度三个相互关联的部分。
七、全文阅读测试暴露出的标题陷阱
35 篇候选中,Undermind 当时只自动取得 2 篇可直接读取的 PDF。我对它们进行了方法审计,重点提取数据、波段、标签、样本量、切分策略、指标、算力、泛化和面积估计方法。
其中一个有代表性的结果来自 Sotomayor 等(2025)。论文标题含有“RGB and multispectral imagery”,容易在摘要式筛选中被理解为 RGB-only 方法;但正文显示:CNN 实际使用 5 波段多光谱数据训练,RGB 影像主要用于辅助参考标签判读,数据空间分辨率也约为厘米级而非 5 m。论文中的通用模型跨站点总体精度明显低于站点专用模型,因此它更适合作为“跨区域泛化困难”的证据,而不是 5 m RGB 裸地分割的直接方案。
这说明专用搜索和 AI 研读应当分工:前者负责把可能相关的论文找出来,后者继续核对题目、摘要和方法之间是否一致。最终笔记还必须区分三类信息:论文明确报告的结果、根据方法作出的推断,以及论文没有报告的事项。
八、这次检索带来的简单启发
目前只形成三个直接、可执行的方向:
- 先把裸地定义和困难样例整理成可复核的标签说明;
- 同时建立传统机器学习与轻量语义分割基线,不急于追逐复杂模型;
- 将地图精度和面积误差分开评价,并在验证时考虑空间区域差异。
这些只是首轮文献带来的学习线索,后续仍需结合实际数据继续收敛。
为了让检索结果不会随着一次对话结束而消失,我把首轮候选论文的书目信息、DOI、主题标签和核验说明整理进 Zotero。下图展示了当前文献库中的实际结果:论文已经形成可搜索、可分组的阅读队列,但目前以元数据和笔记为主,并不代表每篇论文的 PDF 都已经下载。
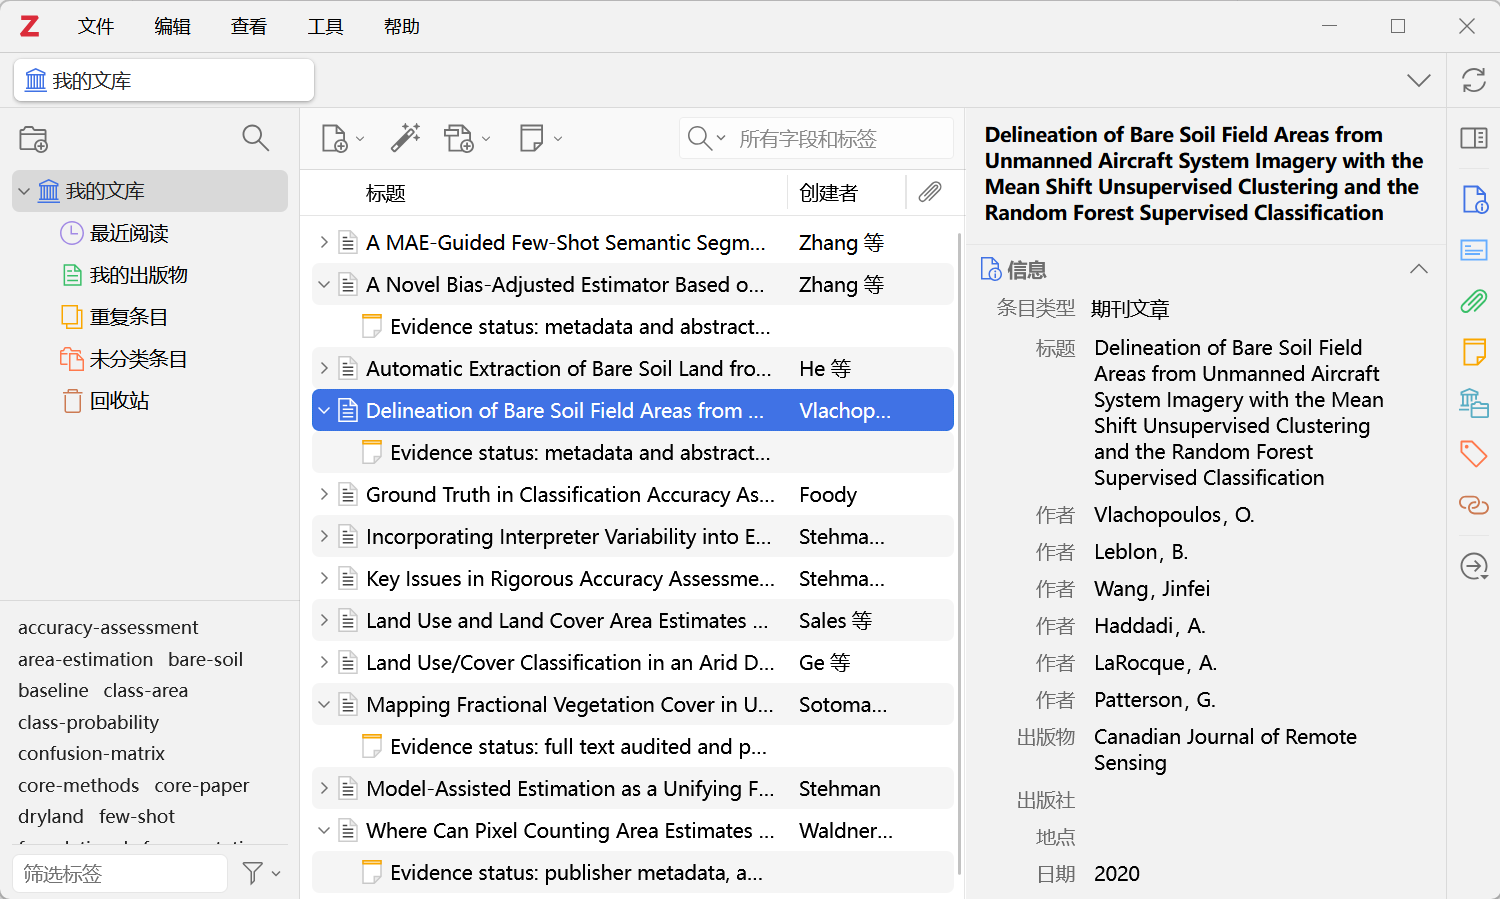
图 4:Zotero 中的首轮检索成果。左侧标签用于按研究主题筛选,中间是论文条目,右侧保留可核验的书目信息。
结语
第一天跑通的最小组合已经能够完成“提出检索问题—搜索真实论文—核验适用性—形成阶段性认识”。工具解决的是信息发现与整理效率,论文能否真正支持研究问题,仍然依赖对数据条件、方法细节和证据边界的人工判断。
下一阶段再继续测试结构化筛选和引文网络扩展,并逐步把当前候选论文转化为更系统的阅读笔记。
参考资料与过程记录
- Undermind 首次检索工作区
- 本文由 AI 工具辅助整理;论文结论优先依据 DOI、出版社页面和已取得全文核验,尚未读取全文的内容仅作候选线索。