从 RGB 到 13 波段:用 TorchGeo 和 EuroSAT 理解多光谱迁移学习
从 RGB 到 13 波段:用 TorchGeo 和 EuroSAT 理解多光谱迁移学习
摘要
普通照片通常只有红、绿、蓝三个通道,而 Sentinel-2 遥感影像可以同时记录13个光谱波段。更多波段意味着模型有机会看见近红外、短波红外等人眼不可见的信息,但也带来了新的问题:普通 ImageNet 预训练模型为什么不能直接读取13波段?GeoTIFF 明明包含地理参考,为什么 TorchGeo 仍把 EuroSAT 归为 NonGeoClassificationDataset?多光谱模型是否一定比 RGB 模型更准确?
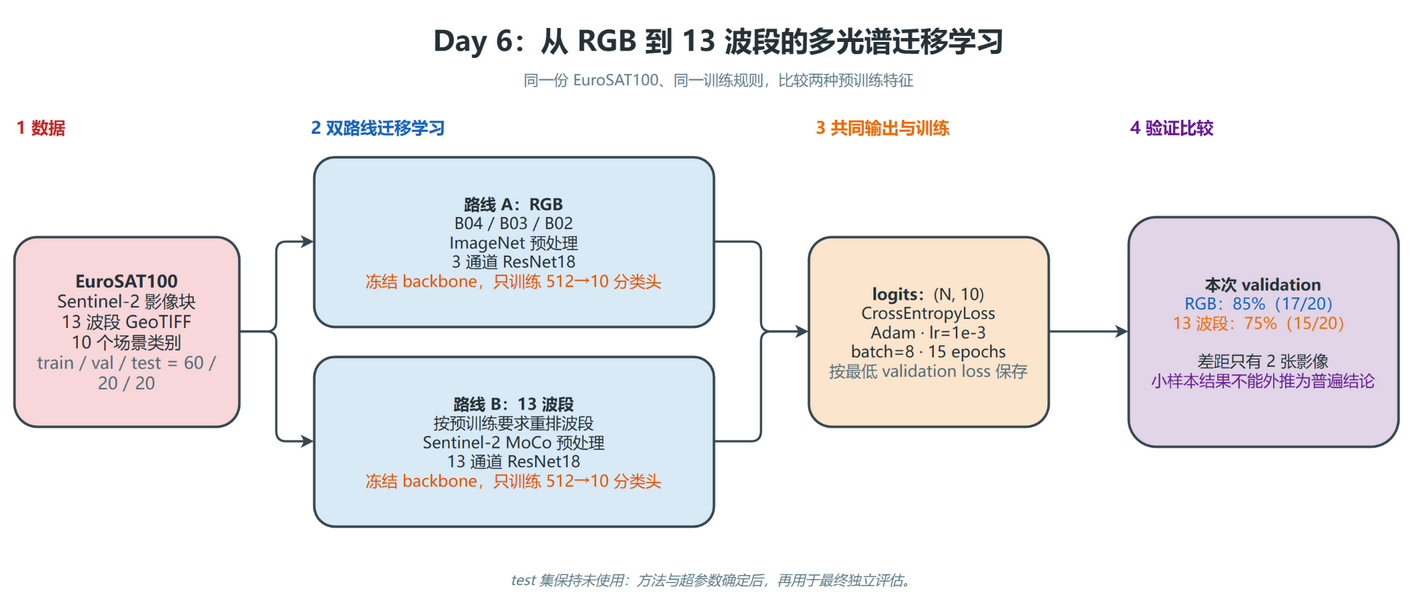
本文使用只有100张影像的 EuroSAT100,完成两条迁移学习路线的可控比较:
- 路线 A:
B04、B03、B02真彩色波段 + ImageNet 预训练 ResNet18; - 路线 B:全部13个波段 + Sentinel-2 MoCo 预训练 ResNet18。
两条路线都冻结特征提取器,只训练相同的 512 → 10 分类头。在本次20张验证影像上,RGB 路线答对17张,准确率为85%;13波段路线答对15张,准确率为75%。两种路线在更大数据集上的差异仍需进一步验证。
1. 今天的技术架构
2. 哪些内容已经学过?
Day 6 建立在前面几天的知识之上。为了让本文聚焦多光谱遥感,不再重复完整推导:
| 已学内容 | 本文如何使用 | 详细出处 |
|---|---|---|
| GeoTIFF、CRS、波段、NoData | 理解遥感文件不只是普通图片 | Day 1–3:从 GIS 数据到 Tensor |
| CHW、HWC、NCHW、dtype | 阅读单幅影像和 batch 的 shape | Day 1–3:从 GIS 数据到 Tensor |
| Dataset、DataLoader、sample、batch | 把 EuroSAT 样本组成训练批次 | PyTorch 二分类训练机制 |
| logits、CrossEntropyLoss、反向传播、validation、checkpoint | 训练并保存分类头 | PyTorch 二分类训练机制 |
| ResNet18、冻结 backbone、更换分类头 | 建立迁移学习模型 | Day 5:预训练 ResNet18 迁移学习分类 |
3. TorchGeo 为什么不能替代 PyTorch?
可以把二者理解成“engine”和“toolkit”。
PyTorch 是训练发动机
PyTorch 负责通用深度学习能力,包括:
Tensor与 GPU 运算;- 神经网络层和模型结构;
- 自动求导与反向传播;
- loss、optimizer 和训练循环;
Dataset、DataLoader等通用数据接口。
这些能力并不限定数据必须是普通照片,也可以处理文本、声音、表格和遥感影像。
TorchGeo 是地理空间扩展
TorchGeo 建立在 PyTorch 之上,补充了遥感和 GIS 常见需求:
- 已封装的遥感数据集;
- 多光谱波段选择与地理元数据处理;
- 按 CRS、空间范围或时间范围进行地理采样的工具;
- 适配 Sentinel、Landsat 等传感器的预训练模型和预处理方法。
4. GeoTIFF 有地理参考,为什么 EuroSAT 仍然是 NonGeoDataset?
这个小问题引发了不少 error,因此这里多占用一些篇幅;已经理解的读者可以跳过本节。
4.1 Geo 与 NonGeo 描述的是 Dataset 接口
这里的“Dataset 接口”,指的是一个数据集对象允许我们怎样向它索取样本,以及它返回什么。
PyTorch Dataset 最基本的使用方式是:
sample = dataset[index]
也就是传入整数索引,取出第几条样本。TorchGeo 的 EuroSAT100 延续了这种方式:
sample = dataset[0]

print(sample.keys())
# dict_keys(['image', 'label'])
它返回的是一张已经裁好的影像和一个场景标签,而不是要求用户用经纬度、空间边界或时间范围查询。
其继承关系可以简化为:
EuroSAT100
└─ EuroSAT
   └─ NonGeoClassificationDataset
      └─ NonGeoDataset
         └─ ImageFolder / PyTorch Dataset
因此,NonGeo 的意思不是“底层文件没有 CRS”,而是:
当前 Dataset 没有把空间位置作为检索、配准和组合样本的核心接口。
4.2 文件能力与接口能力不是一回事
EuroSAT 的多光谱文件是 GeoTIFF,可以保存 CRS、仿射变换和地理范围;但 EuroSAT100[index] 的主要返回契约只有:
{
    "image": image_tensor,
    "label": label_tensor,
}
模型看到的是一张独立影像块以及它属于哪个类别。训练过程中不需要用 bounds 把它与另一层数据做空间相交,也不需要根据时间范围动态裁剪。
真正的 GeoDataset 更适合以下任务:
- 从一幅很大的栅格中按地理范围抽取 patch;
- 让影像与土地覆盖标签在同一空间位置配对;
- 将不同 CRS 或不同分辨率的数据进行空间组合;
- 按位置和时间查询样本。
所以判断一个 Dataset 属于 Geo 还是 NonGeo,不能只看文件扩展名,要看它暴露给使用者的采样接口。
5. 选用数据集:EuroSAT100 中的一条样本
完整 EuroSAT 基于 Sentinel-2 影像构建,包含10个土地利用/土地覆盖类别。EuroSAT100 是 TorchGeo 为教程准备的100张子集,每类10张:6张 train、2张 validation、2张 test。
from torchgeo.datasets import EuroSAT100

dataset = EuroSAT100(
    root=data_root,
    split="train",
    download=True,
    checksum=True,
)

sample = dataset[0]
image = sample["image"]
label = sample["label"]

print(image.shape, image.dtype)
print(label.shape, label.dtype)
本机实际输出为:
image shape: torch.Size([13, 64, 64])
image dtype: torch.float32
label shape: torch.Size([])
label dtype: torch.int64
label: 0 → AnnualCrop
(13,64,64) 使用 CHW 顺序:
13:光谱波段数
64:影像高度
64:影像宽度
这是一项场景分类任务:整张 64×64 patch 只对应一个标签。AnnualCrop 表示这张影像的主要场景被归为一年生作物,并不保证其中每一个像元都是作物。
6. 不同于可见光 RGB,13个波段如何排列并组成 batch?
原始 Dataset 返回的波段顺序为:
B01, B02, B03, B04, B05, B06, B07,
B08, B09, B10, B11, B12, B8A
Tensor 使用从0开始的索引,因此:
band_to_index = {
    band_name: index
    for index, band_name in enumerate(dataset.bands)
}
会得到:
B01 → 0
B02 → 1
B03 → 2
B04 → 3
...
B8A → 12
这里要区分“波段名称”和“Tensor 索引”:
- Sentinel-2 真彩色使用的波段名称是
B04-B03-B02; - 它们在当前 Tensor 中的零基索引是
3-2-1。
如果只说“3-2-1”,很容易把波段编号与数组索引混为一谈。实际代码最好始终通过波段名称查索引,而不是靠记忆写数字。
单个样本的 shape 是 (13,64,64)。设置 batch_size=8 后,DataLoader 会按字段把8条样本堆叠起来:
batch images: (N,C,H,W) = (8,13,64,64)
batch labels: (N,)       = (8,)
与处理普通 RGB 图片时相比,DataLoader 的工作方式没有改变;变化的只是每条影像的通道数由3变成13。它只负责取样和组装 batch,不理解每个通道代表什么,因此波段名称与顺序仍需由我们保证。
7. 多波段的牛刀小试:从假彩色回看 NDVI
这里应写作 NDVI,即归一化植被指数(Normalized Difference Vegetation Index)。它利用近红外波段 B08 与红光波段 B04 的反射差异:
NDVI = (B08 - B04) / (B08 + B04)
NDVI 已在 Day 2 的遥感波段学习 中计算过,这里不重复代码。需要区分的是:NDVI 把近红外与红光的差异计算为数值指标;植被假彩色则把 B08-B04-B03 映射到屏幕 RGB,帮助人眼观察。二者都利用近红外,但用途不同。
作为对照,真彩色使用 B04-B03-B02,外观接近人眼观察;植被假彩色使用 B08-B04-B03,近红外响应较强的区域通常呈红色或粉红色。不过“显示成红色”只能说明近红外响应较强,不能仅凭一张图断言植被一定健康。
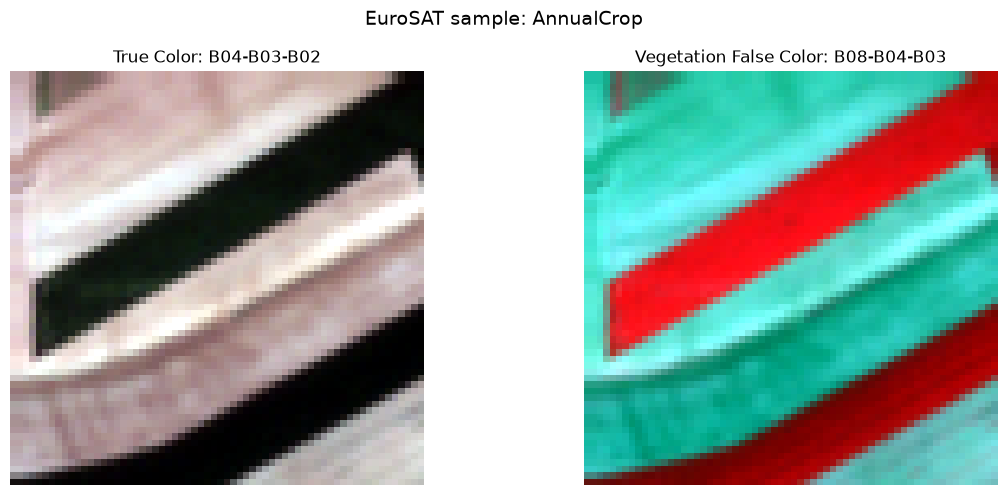
在本次 AnnualCrop 样本中可以观察到:
- 真彩色能看出部分地块边界,但仍有不确定性;
- 真彩色中较暗、类似植被的条带,在假彩色中变成连续红色;
- 近红外视角使部分边界更加清楚;
- 同一 patch 内部并不完全一致。
8. 为什么普通 ResNet18 不能直接读取13波段?
ImageNet 预训练 ResNet18 的第一层卷积为:
Conv2d(3, 64, kernel_size=7, stride=2, padding=3)
第一个数字 3 表示它只准备接收 RGB 三通道。把 (8,13,64,64) 的 batch 直接输入时,模型会报错:权重期待3个输入通道,实际数据却有13个。
这不是数据损坏,而是模型接口与输入 shape 不匹配。
面对13波段输入,通常有三种方案:
| 方案 | 做法 | 优点 | 局限 |
|---|---|---|---|
| 只取 RGB | 从13波段中选择 B04、B03、B02 | 可直接使用成熟的 ImageNet 权重 | 放弃其他光谱信息 |
| 修改第一层 | 把 Conv2d(3,...) 改为 Conv2d(13,...) |
保留全部波段 | 新增通道没有对应的 ImageNet 第一层训练经验 |
| 使用多光谱预训练 | 使用已在13波段 Sentinel-2 上预训练的模型 | 输入通道与传感器更匹配 | 仍需检查波段顺序、预处理与目标地区差异 |
第二种方案不一定等于“整个模型从头训练”。可以保留后面层的 ImageNet 权重,只对新的第一层进行随机初始化、均值复制或其他初始化,然后再微调。但它的第一层终究没有完整的13波段 ImageNet 训练历史。
本次实验选择第一种和第三种,分别代表常见 RGB 基线和多光谱迁移路线。
9. 双路线的数据管线
9.1 RGB + ImageNet
from torchvision.models import ResNet18_Weights as RGBResNet18Weights

rgb_bands = ("B04", "B03", "B02")
rgb_weights = RGBResNet18Weights.DEFAULT
rgb_preprocess = rgb_weights.transforms()

def transform_rgb_sample(sample):
    transformed = sample.copy()
    transformed["image"] = rgb_preprocess(
        sample["image"] / 10000.0
    )
    return transformed
这条路线先除以10000,将数值缩放到近似0~1区间,再使用 ImageNet 权重自带的 resize 和标准化规则。处理后的 batch 为:
(8,3,224,224)
标准化后出现负值是正常现象,因为计算形式类似:
(value - mean) / std
负数表示该像素低于 ImageNet 对应通道均值,不表示地物具有“负反射率”。
9.2 13波段 + Sentinel-2 MoCo
from torchgeo.models import ResNet18_Weights as GeoResNet18Weights

multispectral_bands = (
    "B01", "B02", "B03", "B04", "B05", "B06", "B07",
    "B08", "B8A", "B09", "B10", "B11", "B12",
)

multispectral_weights = (
    GeoResNet18Weights.SENTINEL2_ALL_MOCO
)
multispectral_preprocess = multispectral_weights.transforms
这里最关键的不是“通道数等于13”,而是每个通道的语义位置必须正确。
原始 EuroSAT Dataset 把 B8A 放在最后,而当前 Sentinel-2 预训练权重期待它位于 B08 与 B09 之间。如果不重排,Tensor shape 仍然是 (13,H,W),程序也可能正常运行,但模型会把某个波段误认为另一个波段。这种错误比直接报错更危险,因为它会产生看似合理但语义错位的结果。
处理后的多光谱 batch 为:
(8,13,224,224)
两条路线不需要强行使用完全相同的标准化。公平比较要求的是:
每条路线都使用与自身预训练权重相匹配的输入规则,同时保持数据划分、随机种子、batch size 和训练条件一致。
10. 两个模型如何保持可比?
两条路线都使用 ResNet18,并把原分类层替换成相同的10分类头:
def build_frozen_classifier(model, num_classes, seed=42):
    for parameter in model.parameters():
        parameter.requires_grad = False

    torch.manual_seed(seed)
    model.fc = nn.Linear(model.fc.in_features, num_classes)
    return model.to(device)
这段代码的总体逻辑是:
- 先冻结预训练模型已有参数;
- 用相同随机种子初始化新的分类头;
- 两个分类头都把512维特征转换成10个类别分数;
- optimizer 只接收
requires_grad=True的分类头参数。
模型参数检查结果为:
| 路线 | 第一层输入通道 | 总参数量 | 可训练参数量 |
|---|---|---|---|
| RGB | 3 | 11,181,642 | 5,130 |
| 13波段 | 13 | 11,213,002 | 5,130 |
两个模型总参数量略有不同,是因为13波段模型的第一层卷积需要更多权重;但第一阶段都只训练相同的5,130个分类头参数。
训练时模型保持 eval(),但没有关闭分类头的梯度。这是因为 backbone 已冻结,而 eval() 还能阻止其中的 BatchNorm 继续更新运行统计量。eval() 不等于“任何参数都不能训练”;真正决定参数是否计算梯度的是 requires_grad,真正决定哪些参数被修改的是 optimizer。
11. 从 logits 到 Softmax:模型到底输出了什么?
两个模型的前向输出 shape 都是:
(8,10)
它表示8张影像,每张得到10个类别分数。这些原始分数叫 logits,可以是正数、负数,也不要求相加等于1。
假设一张影像的部分 logits 为:
AnnualCrop     2.0
Forest         0.5
Residential    3.2
...
最大值位于 Residential,因此只想取得预测类别时,可以直接使用:
prediction = logits.argmax(dim=1)
Softmax 会把10个 logits 转换成0到1之间、总和为1的一组数:
probabilities = torch.softmax(logits, dim=1)
其核心形式为:
p_i = exp(z_i) / sum(exp(z_j))
Softmax 不会改变分数的大小顺序,所以最大的 logit 仍然对应最大的 Softmax 值。它的主要作用是把输出转换成更容易阅读的相对概率形式。
训练时使用:
loss = nn.CrossEntropyLoss()(logits, labels)
不要先手动 Softmax。CrossEntropyLoss 需要未经归一化的 logits,并在内部完成数值更稳定的相关计算。
还要注意:Softmax 的90%表示模型在当前10个类别之间给出了很强的相对支持,不等于现实世界中一定有90%的客观正确概率。模型可能因为训练数据偏差而“自信地答错”。
12. 训练设置
完整训练循环与 checkpoint 原理已在 PyTorch 二分类训练机制 中解释。Day 6 只改变数据与预训练模型,训练规则保持一致:
训练集:60张,每类6张
验证集:20张,每类2张
测试集:20张,保持未使用

batch size:8
optimizer:Adam
learning rate:1e-3
epochs:15
loss:CrossEntropyLoss
checkpoint:最低 validation loss
这里把 test 保留下来,是因为 validation 已经参与模型选择。即使 validation 不反向传播,它仍然影响了“保存哪一轮”和“是否调整方案”,所以不能再承担完全独立的最终考试职责。
由于 validation 只有20张影像:
1 / 20 = 5%
模型每多答对或答错一张,accuracy 就会变化5个百分点。这是解释结果时必须记住的尺度。
13. 实验结果
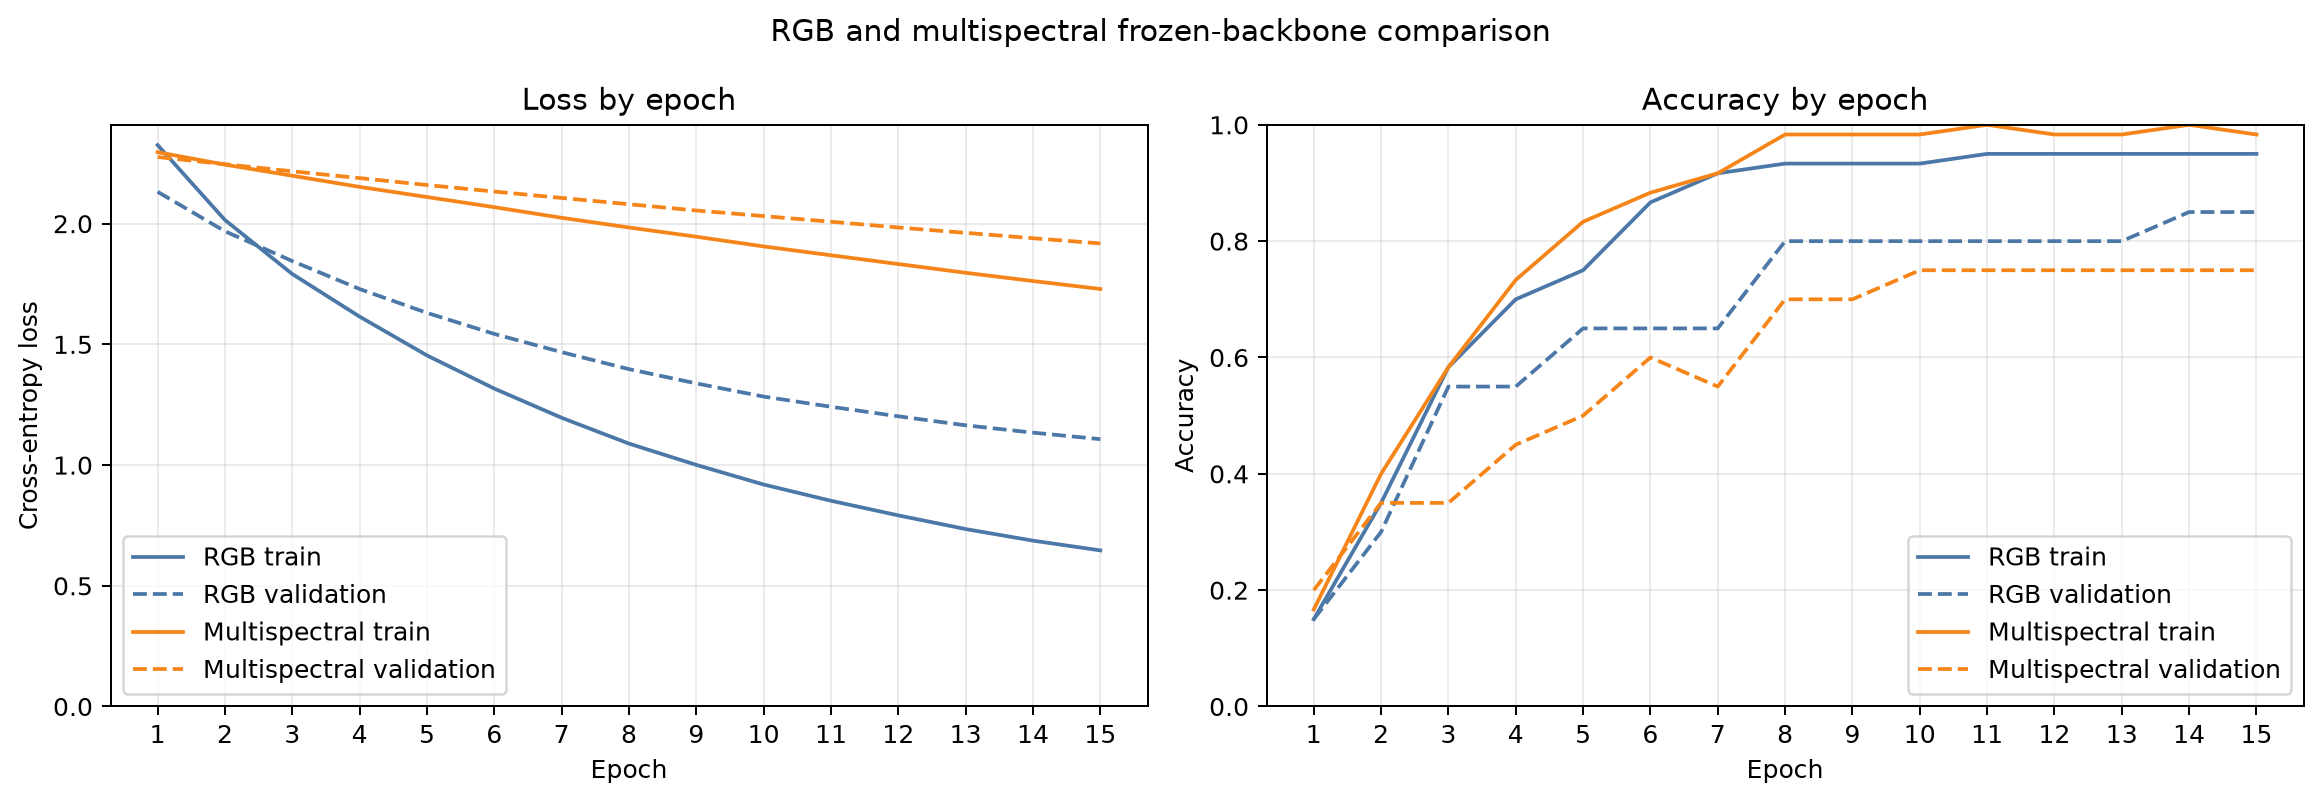
按最低 validation loss 保存模型,本次运行得到:
| 路线 | 选中 epoch | validation loss | validation accuracy | 答对数量 |
|---|---|---|---|---|
| RGB + ImageNet | 15 | 1.1073 | 85% | 17/20 |
| 13波段 + Sentinel-2 MoCo | 15 | 1.9181 | 75% | 15/20 |
13.1 为什么不能直接说 RGB 更好?
85% 与75%相差10个百分点,但在当前验证集上只相差2张影像。EuroSAT100 官方定位就是教程和演示子集,不适合正式 benchmark。
此外,本实验比较的是:
两个冻结的预训练 backbone,在相同超参数下,能否被一个新分类头快速利用。
它没有证明两条路线都达到了各自最优状态。13波段模型可能更适合不同学习率、更多 epoch、逐层解冻或更大的训练集。相同超参数的优点是控制变量清楚,缺点是未必对每条路线都最优。
13.2 为什么13波段训练准确率很高,loss 却仍然较高?
13波段路线在后期的训练 accuracy 已接近100%,但 train loss 仍高于 RGB。这并不矛盾:
- accuracy 只检查正确类别的 logit 是否最大;
- Cross-Entropy loss 还关心正确类别领先其他类别多少。
如果模型经常只是“以很小优势答对”,accuracy 可以很高,但 loss 仍不会很低。反过来,只要最大值位置没有改变,即使模型对正确答案越来越确信,accuracy 也可能保持不变,而 loss 继续下降。
13.3 曲线有没有显示过拟合?
到第15轮为止,两条路线的 validation loss 都还在下降,没有出现典型的“train loss 继续下降、validation loss 转而上升”的拐点。
不过,13波段路线的训练准确率接近100%,验证准确率为75%,已经存在明显的训练—验证差距。这说明它能够记住或拟合60张训练影像,但这种能力还没有完全转化为对验证样本的稳定泛化。
我们仍然保留预先设定的15轮,而不是看完结果后不断延长训练。否则就会逐渐围绕这20张 validation 影像调参,使验证集也被间接“学进去”。
14. 多光谱迁移学习为什么不是“波段越多越好”?
一个在欧洲数据上训练良好的模型,迁移到地貌、季节、气候、传感器处理流程或类别定义不同的地区时,不一定直接有效。这种训练分布与实际使用分布之间的差异,通常称为 域偏移(domain shift)。
迁移学习仍然有价值,因为预训练模型已经学到大量通用纹理、形状和光谱结构,通常比完全随机初始化更容易训练。但迁移学习的正确含义是“利用已有经验作为起点,再用目标区域数据验证和适配”,而不是“拿来就一定准确”。
高质量本地标签仍然重要,它们负责告诉模型:目标地区真正关心哪些类别、这些类别在当地影像上长什么样,以及外部预训练知识在哪些地方失效。
15. 小结
Day 6 的重点不是比较出一个“更强”的模型,而是把遥感波段真正接入迁移学习流程。本次完成了从13波段样本读取、波段顺序检查,到 RGB 与多光谱两条路线训练和验证的完整实验。当前结果只能说明流程已经跑通;面对真实区域,仍要依靠本地数据检验模型是否适用。