预训练 ResNet18 迁移学习:从数据加载到最佳 Checkpoint 的完整实验记录
Week 1 Day 5:预训练 ResNet18 迁移学习分类
先认识今天的两位主角
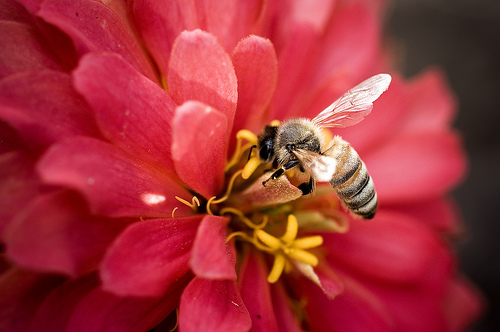
在进入数据加载、冻结 backbone 和保存 checkpoint 之前,不妨先把视线落回任务本身:模型面对的不是两个抽象标签,而是照片中真实的蚂蚁与蜜蜂。它们往往只占画面的一小部分,背景却充满花瓣、色彩和纹理,这正适合检验预训练网络能否从复杂场景中抓住关键视觉线索。
 |
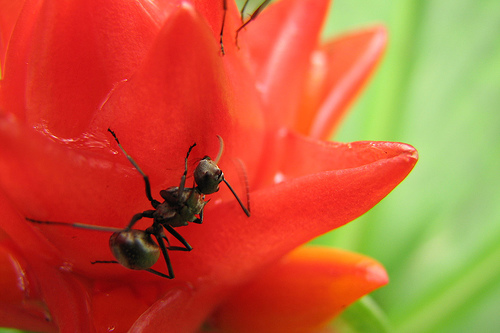 |
| 蜜蜂(bees):绒毛、翅膀与腹部纹理是醒目的辨识线索。 | 蚂蚁(ants):触角、细长的足和分节轮廓更具代表性。 |
对人眼来说,两类昆虫并不难区分;对模型来说,它必须先穿过颜色鲜艳的花朵背景,再把边缘、纹理和局部形状组合成“蚂蚁”或“蜜蜂”的判断。迁移学习的价值也正在这里:无需从零开始学习视觉世界,而是复用 ResNet18 已有的通用视觉经验,只训练一张新的二分类“答题卡”。下面就沿着这条思路,完整走一遍从数据准备到最佳 checkpoint 的实验过程。
摘要
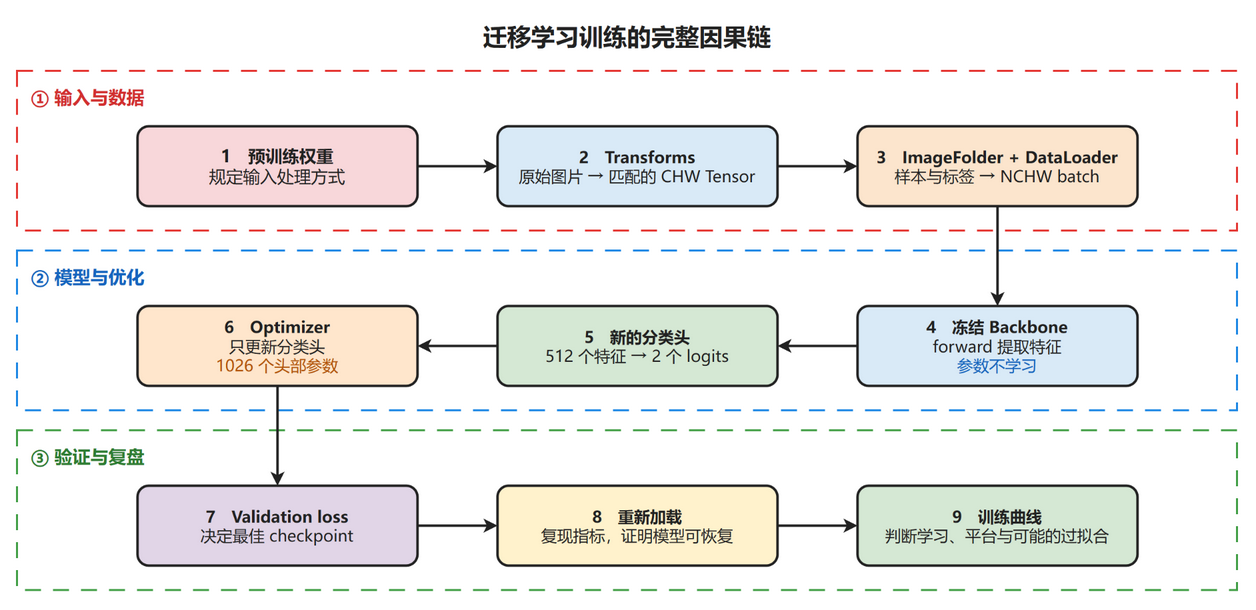
本次实验使用 PyTorch、TorchVision 和 Hymenoptera 小型影像数据集,通过迁移学习完成蚂蚁与蜜蜂的监督分类。实验首先按照 ResNet18_Weights.IMAGENET1K_V1 的要求对影像进行尺寸调整、插值和归一化,再利用 ImageFolder 建立类别映射,并通过 DataLoader 将样本组织成 (N, C, H, W) 形式的批次。模型采用 ImageNet 预训练的 ResNet18,冻结负责提取视觉特征的 backbone,将原有的 Linear(512, 1000) 分类层替换为适用于蚂蚁和蜜蜂二分类任务的 Linear(512, 2),因此训练过程中只更新新分类头的 1026 个参数。训练期间记录样本加权的训练集与验证集 loss 和 accuracy,并以最低 validation loss 为标准保存最佳 checkpoint;最后从磁盘重新建立模型、加载最佳 checkpoint,并重新计算 validation 指标,以验证模型能够被正确恢复和用于影像分类。
一条主线先看懂全局
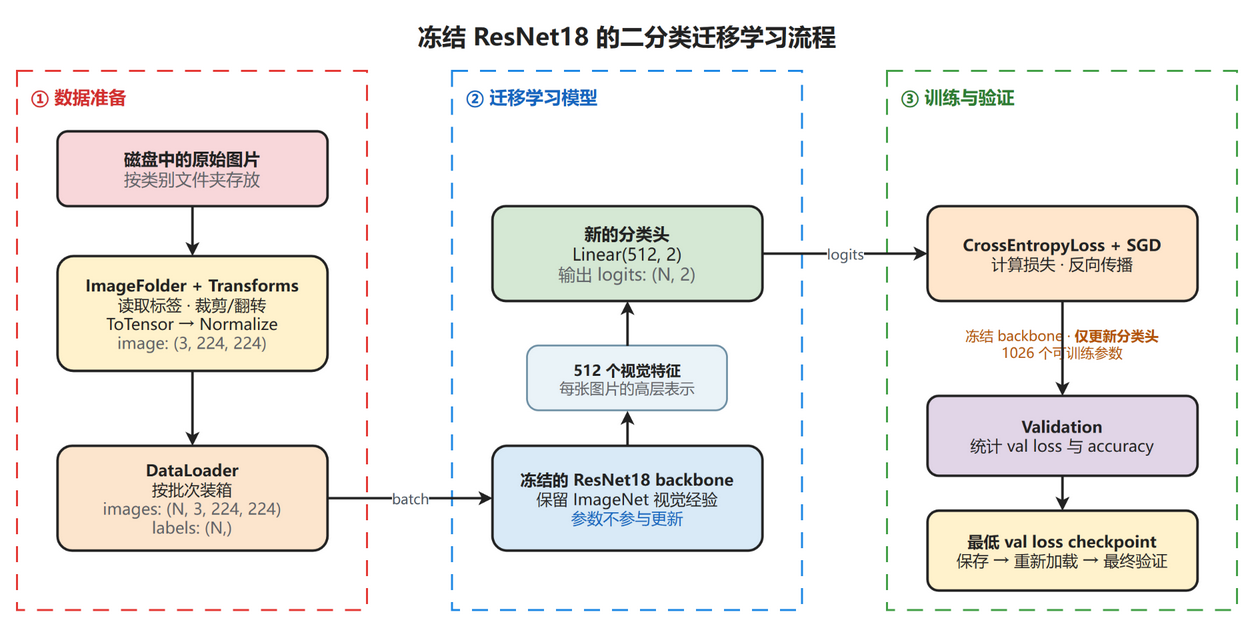
已运行结果与完成证据
| 项目 | 实际结果 |
|---|---|
| train / validation 样本数 | 244 / 153 |
| 类别映射 | ants → 0,bees → 1 |
| 单张影像 shape | (3, 224, 224) |
| batch shape | images (16, 3, 224, 224);labels (16,) |
| 预训练权重 | IMAGENET1K_V1 |
| 全部 / 冻结 / 可训练参数 | 11,177,538 / 11,176,512 / 1,026 |
| 最佳 checkpoint | epoch 8 |
| 最低 validation loss | 0.1369952267291499 |
| 最佳 checkpoint accuracy | 147 / 153 = 0.9607843137 |
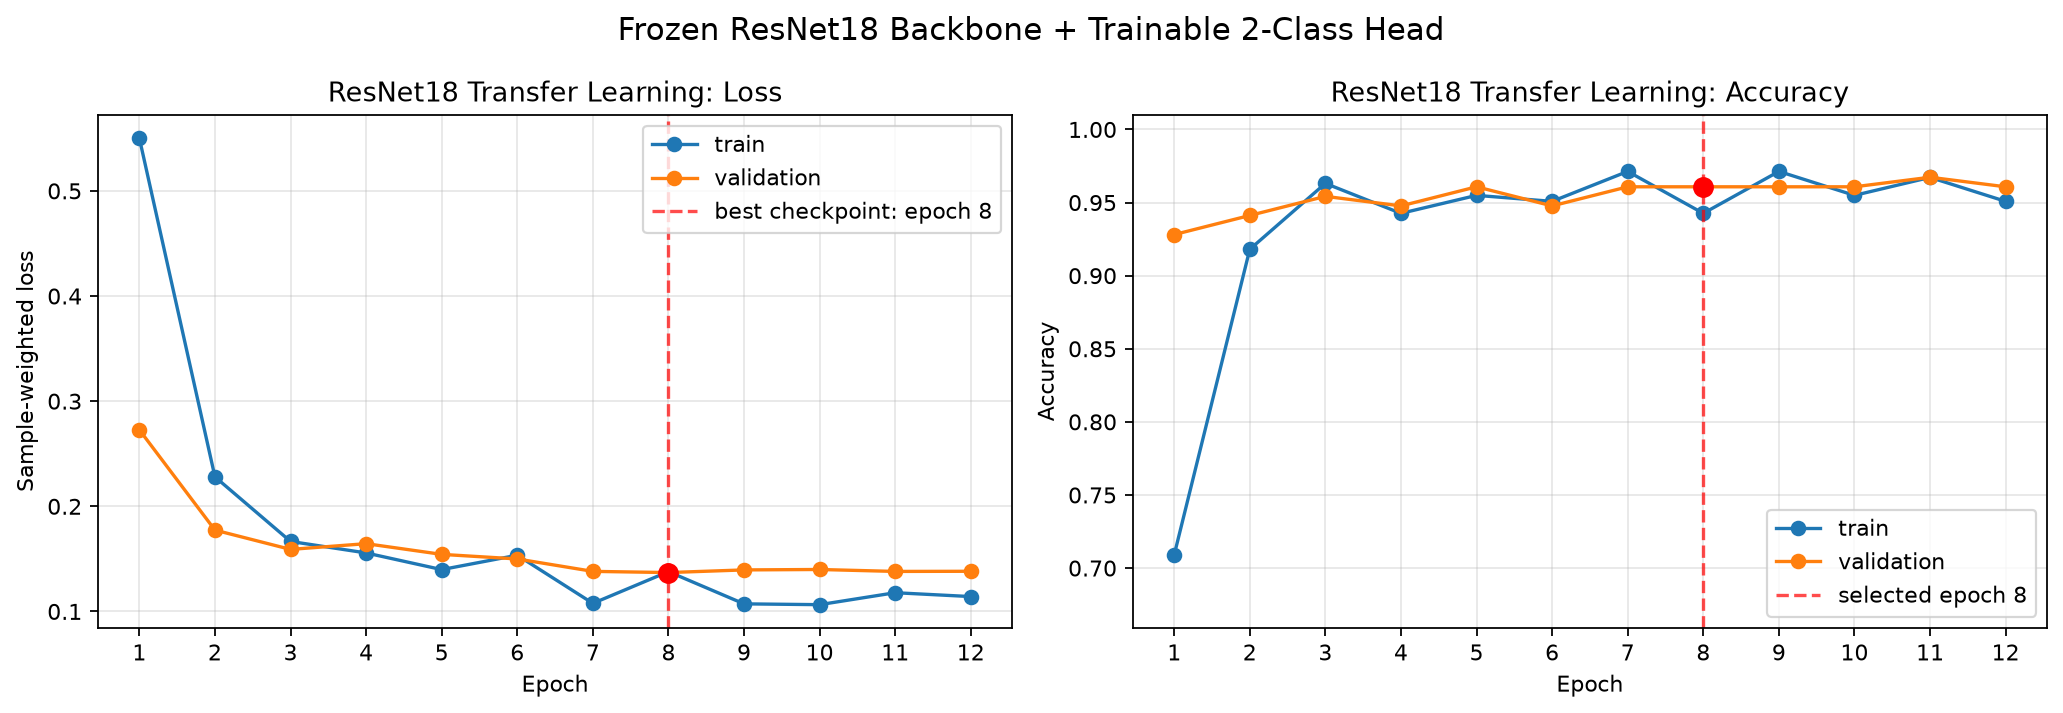
曲线显示:前 3 个 epoch 快速学习,epoch 4–8 改善速度放缓,epoch 8 的 validation loss 最低;epoch 9–12 基本进入平台期。没有出现 train loss 持续下降、validation loss 持续上升并不断分离的明显严重过拟合走势。
正文
0. 数据来源与可复现入口
使用 PyTorch 官方迁移学习教程中的 Hymenoptera 数据:训练集和验证集各含 ants / bees 两类图片。
train用于更新分类头;val用于每个 epoch 的评价与 checkpoint 选择。
查看 / 收起代码
from pathlib import Path
from urllib.request import urlretrieve
from zipfile import ZipFile

project_root = Path(r"C:\Users\81052\Documents\AI & GIS")

day5_raw_dir = project_root / "data" / "raw" / "day5"
zip_path = day5_raw_dir / "hymenoptera_data.zip"
data_dir = day5_raw_dir / "hymenoptera_data"

source_url = (
    "https://download.pytorch.org/tutorial/"
    "hymenoptera_data.zip"
)

day5_raw_dir.mkdir(parents=True, exist_ok=True)


if not data_dir.exists():
    print("正在解压……")
    with ZipFile(zip_path, mode="r") as archive:
        archive.extractall(day5_raw_dir)
else:
    print("数据目录已存在,不重复解压。")

image_extensions = {".jpg", ".jpeg", ".png"}

for split in ["train", "val"]:
    print(f"\n{split}:")

    for class_name in ["ants", "bees"]:
        class_dir = data_dir / split / class_name

        image_count = sum(
            1
            for path in class_dir.iterdir()
            if path.suffix.lower() in image_extensions
        )

        print(f"  {class_name}: {image_count} images")

assert data_dir.exists()
assert (data_dir / "train" / "ants").exists()
assert (data_dir / "train" / "bees").exists()
assert (data_dir / "val" / "ants").exists()
assert (data_dir / "val" / "bees").exists()

print("\nDay 5 数据目录检查通过:", data_dir)
1. 建立“照片加工厂”:Transforms、ImageFolder 与 DataLoader
1.1 为什么要加工图片?
可以把预训练 ResNet18 想成一位对输入格式有明确习惯的考官。原始图片尺寸各不相同,而这版权重的官方预处理使用指定的缩放、224 × 224 裁剪和 ImageNet mean / std。我们要完成两件事:
- 建一条 Transforms 流水线,把原始图片处理成与预训练权重匹配的 Tensor;
- 建一个 装箱车间,用
ImageFolder + DataLoader把样本组成 batch。
技术上,ResNet18 因为使用自适应池化,并非结构上绝对只能接收 224 × 224;这里使用 224 × 224 是为了遵循该预训练权重的标准处理方法,并让同一 batch 中的图片尺寸一致。
1.2 两条流水线为什么不同?
train:随机裁剪/缩放 → 随机水平翻转 → Tensor → 官方 mean/std 归一化
val:  固定 Resize(256) → CenterCrop(224) → Tensor → 官方 mean/std 归一化
- 训练集的随机变化让同一张图片每次读取时略有不同,通常有助于减少、但不能保证一定消除过拟合。
- validation 必须保持确定性,否则同一个模型每次评价面对的题目都在变化,指标就难以比较。
1.3 API 输入、输出、shape 与副作用
| API | 输入 | 输出 | shape 变化 | 副作用 |
|---|---|---|---|---|
weights.transforms() |
PIL 图片 | 与权重匹配的预处理结果 | 最终为 (3,224,224) |
不改写原图 |
RandomResizedCrop |
PIL 图片 | 随机裁剪并缩放后的图片 | 空间尺寸变为 224×224 |
只改变本次内存结果 |
RandomHorizontalFlip |
图片 | 原图或左右镜像 | shape 不变 | 使用随机数,不写文件 |
ToTensor() |
PIL 图片 | float32 Tensor |
常见的 HWC 表达转为 CHW | 像元从 [0,255] 缩放到 [0,1] |
Normalize |
(3,H,W) Tensor |
归一化 Tensor | shape 不变 | 数值可小于 0 或大于 1 |
ImageFolder |
根目录/类别/图片 |
可按索引取样的 Dataset | sample 为 image + label |
扫描目录,不改文件 |
DataLoader |
Dataset | 可迭代 batch | (3,224,224) 堆叠为 (N,3,224,224) |
训练时打乱索引,不打乱图像与标签的配对 |
PIL 图片本身不是 NumPy 数组;转换成数组时通常按 HWC 理解。OpenCV 数组也通常是 HWC,但默认颜色顺序是 BGR。这里
ImageFolder使用 PIL 读取 RGB 图片,再由ToTensor()转成 PyTorch 的 CHW。
查看 / 收起代码
import torch
from torch.utils.data import DataLoader
from torchvision import datasets, transforms
from torchvision.models import ResNet18_Weights

# 明确指定固定版本,避免 DEFAULT 将来指向其他权重。
weights = ResNet18_Weights.IMAGENET1K_V1

# validation 使用权重自带的确定性预处理。
val_transform = weights.transforms()

# train 保持相同尺寸、插值和归一化参数,
# 但加入随机裁剪与水平翻转作为数据增强。
train_transform = transforms.Compose([
    transforms.RandomResizedCrop(
        size=val_transform.crop_size,
        interpolation=val_transform.interpolation,
        antialias=True
    ),
    transforms.RandomHorizontalFlip(),
    transforms.ToTensor(),
    transforms.Normalize(
        mean=val_transform.mean,
        std=val_transform.std
    )
])

print("与权重绑定的 validation transform:")
print(val_transform)

train_dataset = datasets.ImageFolder(
    data_dir / "train",
    transform=train_transform
)

val_dataset = datasets.ImageFolder(
    data_dir / "val",
    transform=val_transform
)

assert train_dataset.class_to_idx == val_dataset.class_to_idx

print("\n类别名称:", train_dataset.classes)
print("类别映射:", train_dataset.class_to_idx)
print("train samples:", len(train_dataset))
print("validation samples:", len(val_dataset))

# ---------- 检查单条 sample ----------
sample_image, sample_label = train_dataset[0]

print("\n单条 sample:")
print("image shape:", sample_image.shape)
print("image dtype:", sample_image.dtype)
print("label:", sample_label, type(sample_label))
print(
    "归一化后数值范围:",
    sample_image.min().item(),
    "到",
    sample_image.max().item()
)

# ---------- 建立 DataLoader ----------
batch_size = 16

train_generator = torch.Generator().manual_seed(42)

train_loader = DataLoader(
    train_dataset,
    batch_size=batch_size,
    shuffle=True,
    num_workers=0,
    generator=train_generator
)

val_loader = DataLoader(
    val_dataset,
    batch_size=batch_size,
    shuffle=False,
    num_workers=0
)

# ---------- 检查一个 batch ----------
batch_images, batch_labels = next(iter(train_loader))

print("\n一个 batch:")
print("images shape:", batch_images.shape)
print("images dtype:", batch_images.dtype)
print("labels shape:", batch_labels.shape)
print("labels dtype:", batch_labels.dtype)
print("前 8 个 labels:", batch_labels[:8])

assert sample_image.shape == (3, 224, 224)
assert batch_images.shape[1:] == (3, 224, 224)
assert batch_labels.ndim == 1

print("\nDay 5 sample/batch shape 检查通过。")
运行输出:
与权重绑定的 validation transform:
ImageClassification(
    crop_size=[224]
    resize_size=[256]
    mean=[0.485, 0.456, 0.406]
    std=[0.229, 0.224, 0.225]
    interpolation=InterpolationMode.BILINEAR
)

类别名称: ['ants', 'bees']
类别映射: {'ants': 0, 'bees': 1}
train samples: 244
validation samples: 153

单条 sample:
image shape: torch.Size([3, 224, 224])
image dtype: torch.float32
label: 0 <class 'int'>
归一化后数值范围: -2.1179039478302 到 2.6051416397094727

一个 batch:
images shape: torch.Size([16, 3, 224, 224])
images dtype: torch.float32
labels shape: torch.Size([16])
labels dtype: torch.int64
前 8 个 labels: tensor([0, 0, 0, 0, 1, 0, 0, 1])

Day 5 sample/batch shape 检查通过。
1.4 从实际输出读懂 shape
本次输出证明:
磁盘中的一张图片
    ↓ train_transform
sample_image:(3, 224, 224),float32
sample_label:Python int,值为 0 或 1
    ↓ DataLoader(batch_size=16)
batch_images:(16, 3, 224, 224)
batch_labels:(16,),int64
(16, 3, 224, 224) 的四个维度依次是:
16:这一批的图片数量;3:RGB 三个通道;224:高度;224:宽度。
归一化后的实际范围约为 [-2.118, 2.605]。这是因为 Normalize 逐通道执行:
所以归一化后的值不再被限制在 [0,1]。Transforms 只在读取样本时处理内存中的图片,不会在磁盘上制造增强后的副本。
2. 迁移学习:保留“眼睛”,更换“答题器”
2.1 我们究竟在迁移什么?
预训练 ResNet18 可以分成两部分:
输入:(N, 3, 224, 224)
    ↓
Backbone:卷积层组成的通用视觉经验
    ↓
每张图片被概括为 512 个高级特征
    ↓
原分类层 Linear(512, 1000)
    ↓
ImageNet 1000 类 logits:(N, 1000)
我们的任务只有 ants / bees,因此:
- 加载 ImageNet 预训练 ResNet18;
- 冻结 backbone,保留其边缘、纹理、局部形状等视觉能力;
- 丢掉
512 → 1000的旧答题卡; - 换成随机初始化的
512 → 2新答题卡。
生活类比:聘请一位有视觉经验的专家,不重写他的视觉知识,只训练他如何用“蚂蚁 / 蜜蜂”这张新答题卡作答。
C 语言可以近似理解为替换结构体成员:
struct Model {
    Backbone pretrained_eyes;
    Linear classifier;
};

model.classifier = new_linear_layer(512, 2);
2.2 冻结不等于停止 forward
parameter.requires_grad = False 的含义是:不为这些参数积累梯度,也不让 optimizer 更新它们。它不会删除参数、不会把参数清零,也不会跳过 forward。
图片仍必须经过 backbone
    ↓
backbone 仍计算 512 个视觉特征
    ↓
只是 backward 不再学习 backbone 参数
如果绕过 backbone,新分类头拿不到 512 个高级特征,也就无从完成分类。
查看 / 收起代码
from torch import nn
from torchvision.models import resnet18

# GPU 可用就使用 GPU,否则退回 CPU。
device = torch.device(
    "cuda" if torch.cuda.is_available() else "cpu"
)

# 1. 创建 ResNet18,并加载指定的 ImageNet 预训练权重。
# 第一次运行时可能下载约 45 MB 的权重到 PyTorch 缓存。
model = resnet18(weights=weights)

print("原始分类层:")
print(model.fc)

# 原分类层接收的特征数量。
backbone_feature_count = model.fc.in_features
class_count = len(train_dataset.classes)

print("\nbackbone 输出特征数:", backbone_feature_count)
print("当前任务类别数:", class_count)

# 2. 冻结目前模型中的所有参数。
for parameter in model.parameters():
    parameter.requires_grad = False

# 3. 创建新的分类头。
# 在固定 seed 后创建,使新分类头的随机初始值可复现。
torch.manual_seed(42)

model.fc = nn.Linear(
    in_features=backbone_feature_count,
    out_features=class_count
)

# 新建的 Linear 参数默认 requires_grad=True。
model = model.to(device)

print("\n替换后的分类层:")
print(model.fc)
print("计算设备:", device)

# ---------- 检查哪些参数可以训练 ----------
total_parameter_count = sum(
    parameter.numel()
    for parameter in model.parameters()
)

trainable_parameter_count = sum(
    parameter.numel()
    for parameter in model.parameters()
    if parameter.requires_grad
)

frozen_parameter_count = (
    total_parameter_count - trainable_parameter_count
)

print("\n全部参数:", total_parameter_count)
print("冻结参数:", frozen_parameter_count)
print("可训练参数:", trainable_parameter_count)

print(
    "第一层卷积是否可训练:",
    model.conv1.weight.requires_grad
)

print(
    "新分类层 weight 是否可训练:",
    model.fc.weight.requires_grad
)

print(
    "新分类层 bias 是否可训练:",
    model.fc.bias.requires_grad
)

# ---------- 用 4 张图片验证 forward shape ----------
model.eval()

example_images = batch_images[:4].to(device)

with torch.no_grad():
    example_logits = model(example_images)

print("\nforward shape 检查:")
print("模型输入:", example_images.shape)
print("模型输出 logits:", example_logits.shape)
print("前两张影像的 logits:\n", example_logits[:2])

assert example_images.shape == (4, 3, 224, 224)
assert example_logits.shape == (4, 2)
assert trainable_parameter_count == 512 * 2 + 2
assert model.conv1.weight.requires_grad is False
assert model.fc.weight.requires_grad is True

print("\nResNet18 冻结与分类层替换检查通过。")
运行输出:
Downloading: "https://download.pytorch.org/models/resnet18-f37072fd.pth" to C:\Users\81052/.cache\torch\hub\checkpoints\resnet18-f37072fd.pth
100%|██████████| 44.7M/44.7M [00:02<00:00, 18.0MB/s]
原始分类层:
Linear(in_features=512, out_features=1000, bias=True)

backbone 输出特征数: 512
当前任务类别数: 2

替换后的分类层:
Linear(in_features=512, out_features=2, bias=True)
计算设备: cuda

全部参数: 11177538
冻结参数: 11176512
可训练参数: 1026
第一层卷积是否可训练: False
新分类层 weight 是否可训练: True
新分类层 bias 是否可训练: True

forward shape 检查:
模型输入: torch.Size([4, 3, 224, 224])
模型输出 logits: torch.Size([4, 2])
前两张影像的 logits:
 tensor([[-1.0348,  0.6320],
        [-0.3837,  0.4925]], device='cuda:0')

ResNet18 冻结与分类层替换检查通过。
2.3 参数数量、bias 与 forward shape
实际输出显示:
原分类层:Linear(512, 1000)
新分类层:Linear(512, 2)
全部参数:11,177,538
冻结参数:11,176,512
可训练参数:1,026
新分类层的参数量为:
Linear 层对每个类别计算的基本形式是:
- weight 决定 512 个特征如何组合;
- bias 是每个输出类别独立的基础偏移量,类似出租车起步价;即使输入特征全为 0,输出也不必被强制为 0;
- 对两个类别各有一个 bias,所以共有 2 个 bias。
forward 验证为:
4 张图片:(4, 3, 224, 224)
    ↓ frozen backbone
4 组特征:(4, 512)
    ↓ Linear(512, 2)
logits:(4, 2)
(4,2) 表示 4 张图片各有两个原始类别分数:索引 0 对应 ants,索引 1 对应 bees。logits 不是概率,训练前不需要手动 softmax。
3. 只训练分类头
3.1 与 Day 4 相同的发动机,新在哪里?
训练的五步仍是:
zero_grad → forward → loss → backward → step
Day 5 新增三个重点:
- 模型、images、labels 必须位于同一设备,本次使用
cuda; - optimizer 只接收
model.fc.parameters(),所以只管理 1026 个参数; - 严格冻结 backbone 时,还要处理 BatchNorm 的运行统计量。
3.2 为什么是 model.eval() + model.fc.train()?
ResNet18 的 BatchNorm 除了可训练的 weight / bias,还有 running_mean 和 running_var buffers。requires_grad=False 只能冻结参数梯度,不能阻止 BatchNorm 在 train 模式下更新这些 buffers。
因此分类头训练阶段使用:
model.eval()      # backbone 的 BatchNorm 保持固定
model.fc.train()  # 明确表达:只训练分类头
eval() 只切换 Dropout / BatchNorm 等模块的行为,不会关闭梯度;torch.no_grad() 才会关闭梯度记录。当前头部只是 Linear,train / eval 模式下计算相同,但单独设为 train 能清楚表达意图。
训练集随机增强发生在 Dataset 中,与模型处于 eval 或 train 模式无关。
3.3 指标为什么要按样本加权?
CrossEntropyLoss 默认返回当前 batch 的平均 loss。最后一个 batch 可能不足 16 张,因此先乘回该 batch 的样本数,再对所有样本求平均:
这样每张样本权重相同,而不是让小 batch 与完整 batch 拥有相同权重。
momentum=0.9 可类比带惯性的下坡小车:SGD 的更新方向不仅使用当前梯度,还累计过去的方向信息,以减少震荡并加快某些方向上的前进。它会产生 optimizer 状态,所以 checkpoint 同时保存 optimizer_state_dict。
查看 / 收起代码
from pathlib import Path

# ---------- 训练配置 ----------
learning_rate = 0.001
momentum = 0.9
num_epochs = 12

loss_fn = nn.CrossEntropyLoss()

# 关键:optimizer 只管理新的分类头。
optimizer = torch.optim.SGD(
    model.fc.parameters(),
    lr=learning_rate,
    momentum=momentum
)

history = {
    "train_loss": [],
    "train_accuracy": [],
    "val_loss": [],
    "val_accuracy": []
}

best_val_loss = float("inf")

checkpoint_path = (
    project_root
    / "outputs"
    / "day5"
    / "best_resnet18_head.pt"
)

checkpoint_path.parent.mkdir(
    parents=True,
    exist_ok=True
)

print("训练设备:", device)
print("optimizer 管理的参数量:", sum(
    parameter.numel()
    for group in optimizer.param_groups
    for parameter in group["params"]
))
print("checkpoint:", checkpoint_path)

# ---------- 正式训练 ----------
for epoch in range(num_epochs):
    # ===== Training =====
    # Backbone 保持 eval,避免 BatchNorm 统计值变化。
    # 分类头保持 train,并且梯度仍然开启。
    model.eval()
    model.fc.train()

    train_loss_sum = 0.0
    train_correct = 0
    train_sample_count = 0

    for images, labels in train_loader:
        images = images.to(device)
        labels = labels.to(device)

        optimizer.zero_grad()

        logits = model(images)
        loss = loss_fn(logits, labels)

        loss.backward()
        optimizer.step()

        batch_sample_count = labels.size(0)

        train_loss_sum += (
            loss.item() * batch_sample_count
        )

        train_correct += (
            logits.argmax(dim=1) == labels
        ).sum().item()

        train_sample_count += batch_sample_count

    train_loss = (
        train_loss_sum / train_sample_count
    )

    train_accuracy = (
        train_correct / train_sample_count
    )

    # ===== Validation =====
    model.eval()

    val_loss_sum = 0.0
    val_correct = 0
    val_sample_count = 0

    with torch.no_grad():
        for images, labels in val_loader:
            images = images.to(device)
            labels = labels.to(device)

            logits = model(images)
            loss = loss_fn(logits, labels)

            batch_sample_count = labels.size(0)

            val_loss_sum += (
                loss.item() * batch_sample_count
            )

            val_correct += (
                logits.argmax(dim=1) == labels
            ).sum().item()

            val_sample_count += batch_sample_count

    val_loss = val_loss_sum / val_sample_count
    val_accuracy = val_correct / val_sample_count

    history["train_loss"].append(train_loss)
    history["train_accuracy"].append(train_accuracy)
    history["val_loss"].append(val_loss)
    history["val_accuracy"].append(val_accuracy)

    # validation loss 刷新最低纪录时保存。
    if val_loss < best_val_loss:
        best_val_loss = val_loss

        torch.save(
            {
                "epoch": epoch + 1,
                "model_state_dict": model.state_dict(),
                "optimizer_state_dict": optimizer.state_dict(),
                "validation_loss": val_loss,
                "validation_accuracy": val_accuracy,
                "class_to_idx": train_dataset.class_to_idx,
                "weights_name": weights.name,
                "backbone_frozen": True,
                "learning_rate": learning_rate,
                "momentum": momentum,
                "batch_size": batch_size
            },
            checkpoint_path
        )

        checkpoint_status = "已保存新最佳模型"
    else:
        checkpoint_status = ""

    print(
        f"Epoch {epoch + 1:02d}/{num_epochs} | "
        f"train loss {train_loss:.4f}, "
        f"acc {train_accuracy:.4f} | "
        f"val loss {val_loss:.4f}, "
        f"acc {val_accuracy:.4f} "
        f"{checkpoint_status}"
    )

print("\n最低 validation loss:", best_val_loss)
print("最佳 checkpoint:", checkpoint_path)
运行输出:
训练设备: cuda
optimizer 管理的参数量: 1026
checkpoint: C:\Users\81052\Documents\AI & GIS\outputs\day5\best_resnet18_head.pt
Epoch 01/12 | train loss 0.5501, acc 0.7090 | val loss 0.2727, acc 0.9281 已保存新最佳模型
Epoch 02/12 | train loss 0.2280, acc 0.9180 | val loss 0.1774, acc 0.9412 已保存新最佳模型
Epoch 03/12 | train loss 0.1666, acc 0.9631 | val loss 0.1590, acc 0.9542 已保存新最佳模型
Epoch 04/12 | train loss 0.1557, acc 0.9426 | val loss 0.1645, acc 0.9477
Epoch 05/12 | train loss 0.1398, acc 0.9549 | val loss 0.1543, acc 0.9608 已保存新最佳模型
Epoch 06/12 | train loss 0.1535, acc 0.9508 | val loss 0.1499, acc 0.9477 已保存新最佳模型
Epoch 07/12 | train loss 0.1077, acc 0.9713 | val loss 0.1381, acc 0.9608 已保存新最佳模型
Epoch 08/12 | train loss 0.1379, acc 0.9426 | val loss 0.1370, acc 0.9608 已保存新最佳模型
Epoch 09/12 | train loss 0.1072, acc 0.9713 | val loss 0.1395, acc 0.9608
Epoch 10/12 | train loss 0.1065, acc 0.9549 | val loss 0.1399, acc 0.9608
Epoch 11/12 | train loss 0.1178, acc 0.9672 | val loss 0.1381, acc 0.9673
Epoch 12/12 | train loss 0.1142, acc 0.9508 | val loss 0.1382, acc 0.9608

最低 validation loss: 0.1369952267291499
最佳 checkpoint: C:\Users\81052\Documents\AI & GIS\outputs\day5\best_resnet18_head.pt
3.4 从 12 个 epoch 读懂训练过程
- epoch 1–3:快速学习。 validation accuracy 第一轮已达到
0.9281,说明预训练 backbone 已提供有用特征,新头部只需学习新的特征到类别映射。 - epoch 4–8:继续改善但速度放缓。 指标有小幅波动,epoch 8 的 validation loss 达到最低
0.136995。 - epoch 9–12:平台期。 validation loss 约在
0.138附近横盘,继续训练的收益已经有限。
train 指标比 validation 更容易波动,主要因为:
- train 每次读取会随机裁剪和翻转,同一图片每轮难度不同;
- train 指标是在一个 epoch 内边更新参数边累计,包含该轮早期与后期的不同模型状态;
- validation 使用固定预处理,并在 epoch 结束后用同一个静态模型统一评价。
这里没有出现明显的严重过拟合,但这不等于证明模型永远不会过拟合;小数据、固定 validation 集以及只运行 12 个 epoch 都限制了结论范围。
3.5 为什么 checkpoint 选 epoch 8,而不是 epoch 11?
epoch 11 的 validation accuracy 更高:148/153 = 0.9673;epoch 8 为 147/153 = 0.9608。但我们在训练前已规定按 最低 validation loss 选模型:
- accuracy 只统计 argmax 后最终答对多少张,是离散台阶;
- cross-entropy loss 还考虑正确类别的相对分数,并重罚自信的错误预测;
- 一张临界图片跨过决策边界可能让 accuracy 上升,但其他图片的概率分配略微变差,平均 loss 仍可能上升。
因此严格选择 epoch 8,避免看到结果后临时改变模型选择规则。最低 validation loss 只表示它在当前 validation 与既定指标下最好,不等于证明其概率完美校准或对所有未知数据都最优。
4. 从磁盘重建并验证最佳 checkpoint
训练结束时,内存中的 model 已经来到 epoch 12;最佳 checkpoint 却来自 epoch 8。直接验证当前模型,只能证明 epoch 12 可用,不能证明磁盘里的最佳版本能恢复。
所以重新走一遍“程序重启后的恢复流程”:
resnet18(weights=None):只建空结构
    ↓
把 fc 改成 Linear(512,2)
    ↓
torch.load:读取 checkpoint
    ↓
load_state_dict:填入 backbone、分类头和 BatchNorm buffers
    ↓
重新计算全部 validation
state_dict 保存数值状态,不保存 Python 模型结构,所以必须先创建匹配的结构。weights=None 避免再次加载 ImageNet 初始权重,因为 checkpoint 已包含完整模型状态。
查看 / 收起代码
# ---------- 读取 checkpoint ----------
checkpoint = torch.load(
    checkpoint_path,
    map_location=device,
    weights_only=True
)

print("checkpoint 字段:")
print(checkpoint.keys())

print("\n保存的 epoch:", checkpoint["epoch"])
print("保存的 validation loss:", checkpoint["validation_loss"])
print("保存的 validation accuracy:", checkpoint["validation_accuracy"])
print("类别映射:", checkpoint["class_to_idx"])
print("预训练权重版本:", checkpoint["weights_name"])
print("backbone frozen:", checkpoint["backbone_frozen"])

# ---------- 重建相同的模型结构 ----------
# weights=None:只创建结构,不重新下载或加载预训练权重。
# checkpoint 的 state_dict 随后会覆盖全部模型参数。
restored_model = resnet18(weights=None)

restored_feature_count = (
    restored_model.fc.in_features
)

for parameter in restored_model.parameters():
    parameter.requires_grad = False

restored_model.fc = nn.Linear(
    in_features=restored_feature_count,
    out_features=len(checkpoint["class_to_idx"])
)

load_result = restored_model.load_state_dict(
    checkpoint["model_state_dict"]
)

restored_model = restored_model.to(device)
restored_model.eval()

print("\n参数加载结果:", load_result)

# ---------- 重新计算全部 validation ----------
restored_val_loss_sum = 0.0
restored_val_correct = 0
restored_val_sample_count = 0

first_batch_predictions = None
first_batch_labels = None

with torch.no_grad():
    for batch_index, (images, labels) in enumerate(
        val_loader
    ):
        images = images.to(device)
        labels = labels.to(device)

        logits = restored_model(images)
        loss = loss_fn(logits, labels)

        batch_sample_count = labels.size(0)

        restored_val_loss_sum += (
            loss.item() * batch_sample_count
        )

        predictions = logits.argmax(dim=1)

        restored_val_correct += (
            predictions == labels
        ).sum().item()

        restored_val_sample_count += (
            batch_sample_count
        )

        if batch_index == 0:
            first_batch_predictions = (
                predictions.cpu()
            )
            first_batch_labels = labels.cpu()

restored_val_loss = (
    restored_val_loss_sum
    / restored_val_sample_count
)

restored_val_accuracy = (
    restored_val_correct
    / restored_val_sample_count
)

print("\n恢复后 validation:")
print("sample count:", restored_val_sample_count)
print("correct:", restored_val_correct)
print("loss:", restored_val_loss)
print("accuracy:", restored_val_accuracy)

# ---------- 把数字标签翻译成类别名 ----------
idx_to_class = {
    class_index: class_name
    for class_name, class_index
    in checkpoint["class_to_idx"].items()
}

print("\n第一个 validation batch 的前 8 项:")

for index in range(8):
    predicted_index = (
        first_batch_predictions[index].item()
    )

    true_index = first_batch_labels[index].item()

    print(
        f"{index}: "
        f"predicted={idx_to_class[predicted_index]}, "
        f"true={idx_to_class[true_index]}"
    )

# ---------- 验证恢复结果 ----------
assert load_result.missing_keys == []
assert load_result.unexpected_keys == []

assert abs(
    restored_val_loss
    - checkpoint["validation_loss"]
) < 1e-6

assert abs(
    restored_val_accuracy
    - checkpoint["validation_accuracy"]
) < 1e-12

print("\n最佳 checkpoint 恢复验证通过。")
运行输出:
checkpoint 字段:
dict_keys(['epoch', 'model_state_dict', 'optimizer_state_dict', 'validation_loss', 'validation_accuracy', 'class_to_idx', 'weights_name', 'backbone_frozen', 'learning_rate', 'momentum', 'batch_size'])

保存的 epoch: 8
保存的 validation loss: 0.1369952267291499
保存的 validation accuracy: 0.9607843137254902
类别映射: {'ants': 0, 'bees': 1}
预训练权重版本: IMAGENET1K_V1
backbone frozen: True

参数加载结果: <All keys matched successfully>

恢复后 validation:
sample count: 153
correct: 147
loss: 0.1369952267291499
accuracy: 0.9607843137254902

第一个 validation batch 的前 8 项:
0: predicted=ants, true=ants
1: predicted=ants, true=ants
2: predicted=ants, true=ants
3: predicted=ants, true=ants
4: predicted=ants, true=ants
5: predicted=ants, true=ants
6: predicted=bees, true=ants
7: predicted=ants, true=ants

最佳 checkpoint 恢复验证通过。
4.1 恢复结果说明了什么?
<All keys matched successfully> 表示没有缺失 key,也没有意外 key,模型结构与 checkpoint 完全匹配。
保存时:epoch 8,loss 0.1369952267291499,accuracy 147/153
恢复后:        loss 0.1369952267291499,accuracy 147/153
两个指标完全一致,证明 checkpoint 不只是“文件存在”,而是能实际恢复并完成 validation forward。前 8 个展示样本中,第 7 项真实为 ants、预测为 bees,这是一个具体错误案例;本节只确认推理链路,不提前展开 Day 6 的错误样本分析。
5. 绘制并解释训练曲线
曲线把 12 行离散日志变成随 epoch 变化的趋势:
正常学习:train loss ↓,validation loss ↓
接近平台:train / validation loss 不再明显改善
可能过拟合:train loss 继续下降,validation loss 持续上升并逐渐分离
单个 epoch 的轻微上升不等于过拟合,要观察连续趋势。红色竖线和红点标记的是按最低 validation loss 选出的 epoch 8。
axvline画选择位置的竖线;scatter标记选中点;fig.savefig把图写入outputs/day5/training_curves.png;- 绘图只读取
history,不会修改模型或训练结果。
查看 / 收起代码
import matplotlib.pyplot as plt

assert len(history["train_loss"]) == num_epochs
assert len(history["val_loss"]) == num_epochs

epochs = list(range(1, num_epochs + 1))

best_epoch = checkpoint["epoch"]
best_index = best_epoch - 1

curve_path = (
    checkpoint_path.parent
    / "training_curves.png"
)

fig, axes = plt.subplots(
    1,
    2,
    figsize=(13, 4.5)
)

# ---------- Loss ----------
axes[0].plot(
    epochs,
    history["train_loss"],
    marker="o",
    label="train"
)

axes[0].plot(
    epochs,
    history["val_loss"],
    marker="o",
    label="validation"
)

axes[0].axvline(
    best_epoch,
    color="red",
    linestyle="--",
    alpha=0.7,
    label=f"best checkpoint: epoch {best_epoch}"
)

axes[0].scatter(
    best_epoch,
    history["val_loss"][best_index],
    color="red",
    s=70,
    zorder=5
)

axes[0].set_title("ResNet18 Transfer Learning: Loss")
axes[0].set_xlabel("Epoch")
axes[0].set_ylabel("Sample-weighted loss")
axes[0].set_xticks(epochs)
axes[0].grid(alpha=0.3)
axes[0].legend()

# ---------- Accuracy ----------
axes[1].plot(
    epochs,
    history["train_accuracy"],
    marker="o",
    label="train"
)

axes[1].plot(
    epochs,
    history["val_accuracy"],
    marker="o",
    label="validation"
)

axes[1].axvline(
    best_epoch,
    color="red",
    linestyle="--",
    alpha=0.7,
    label=f"selected epoch {best_epoch}"
)

axes[1].scatter(
    best_epoch,
    history["val_accuracy"][best_index],
    color="red",
    s=70,
    zorder=5
)

all_accuracies = (
    history["train_accuracy"]
    + history["val_accuracy"]
)

accuracy_lower_limit = max(
    0.0,
    min(all_accuracies) - 0.05
)

axes[1].set_title("ResNet18 Transfer Learning: Accuracy")
axes[1].set_xlabel("Epoch")
axes[1].set_ylabel("Accuracy")
axes[1].set_xticks(epochs)
axes[1].set_ylim(accuracy_lower_limit, 1.01)
axes[1].grid(alpha=0.3)
axes[1].legend()

fig.suptitle(
    "Frozen ResNet18 Backbone + Trainable 2-Class Head",
    fontsize=14
)

plt.tight_layout()

fig.savefig(
    curve_path,
    dpi=160,
    bbox_inches="tight"
)

plt.show()

print("训练曲线已保存:", curve_path)
运行输出:
<Figure size 1300x450 with 2 Axes>
训练曲线已保存: C:\Users\81052\Documents\AI & GIS\outputs\day5\training_curves.png
6. 结论与复盘
曲线结论
- epoch 1–3 的 loss 快速下降,说明迁移来的视觉特征对新任务有效;
- epoch 4–8 仍在改善,但速度下降;
- epoch 8 的 validation loss 最低,因此成为最佳 checkpoint;
- epoch 9–12 更接近平台期,而不是继续明显学习或严重过拟合;
- validation accuracy 每多答对一张就变化约
1/153 ≈ 0.00654,所以 accuracy 曲线呈台阶状;loss 是连续指标,能在 accuracy 不变时继续变化。
学习思路链