从 GIS 栅格到 PyTorch 张量:我的 GeoAI 学习笔记(Day 1—Day 3)
刚开始接触 GeoAI 时,我很容易把地图、遥感影像和深度学习看成三套独立知识。经过前三天的练习,我逐渐发现它们其实处在同一条数据链上:GIS 负责说明数据“在哪里、是什么”,遥感波段提供可分析的观测值,而 NumPy 与 PyTorch 则把这些观测值组织成模型能够处理的数组和张量。
这篇笔记记录了我从 QGIS 数据体检,到计算 Sentinel-2 NDVI,再到理解 CHW、HWC 和 NCHW 的学习过程。
Day 1:先读懂 GIS 数据,再谈分析
第一天的目标不是制作复杂地图,而是学习给数据做“体检”。我在 QGIS 3.44.12 中加载了 GeoPackage 矢量图层和 GeoTIFF 栅格,重点检查数据来源、CRS、范围、单位、像元大小、波段、数据类型和 NoData。
图层 CRS 与工程 CRS
图层 CRS 描述源数据中的坐标代表什么,工程 CRS 决定地图画布如何显示这些图层。QGIS 可以进行即时坐标转换,让不同 CRS 的图层叠加显示,但这种显示转换不会自动改写源数据的 CRS。
我接触到的两个典型坐标系统是:
EPSG:4326:使用经纬度表示位置,单位是度,适合全球定位、存储和交换数据。- UTM 投影坐标系:把限定区域投影到平面,单位通常是米,更适合距离、面积和区域空间分析。
这让我意识到,经纬度虽然能描述位置,却不能直接当作固定的地面长度使用。选择 CRS 不只是为了让图层“显示正确”,还会影响后续测量与分析是否合理。
GeoTIFF 不只是普通图片
PNG、JPG 主要保存用于显示的颜色,而 GeoTIFF 还可以保存 CRS、地理范围、像元大小,以及像元与地球坐标之间的关系。因此,QGIS 知道一幅 GeoTIFF 应该放到地图上的什么位置。
栅格的宽和高表示像元数量;空间分辨率则表示一个像元覆盖多大的地面范围。例如,10 m 分辨率意味着一个像元约覆盖 10 m × 10 m。目标若远小于一个像元,它的信号就会与道路、植被、阴影或屋顶混合,形状与边界也更难保留。这不仅影响目视判读,也限制模型能够识别的最小目标。
NoData 不等于 0
NoData 表示该位置没有有效观测,数值 0 则可能是合法数据,例如海拔 0 米。若把两者混为一谈,统计、显示和空间分析都会产生偏差。
我还验证了一个很重要的原则:交换 RGB 通道、调整亮度和对比度,只会改变渲染规则。QGIS 仍然读取原始像元值,再按当前样式映射为屏幕颜色;这些操作不会改写源 GeoTIFF。
Day 2:从“看影像”到“分析波段”
第二天使用的是台北盆地 Sentinel-2 Level-2A 影像,场景 ID 为 S2B_51RUH_20260114_0_L2A,空间分辨率为 10 m,采用 EPSG:32651(WGS 84 / UTM zone 51N)。练习数据包含四个波段:
| 本地波段 | Sentinel-2 波段 | 含义 |
|---|---|---|
| Band 1 | B02 | 蓝光 |
| Band 2 | B03 | 绿光 |
| Band 3 | B04 | 红光 |
| Band 4 | B08 | 近红外 |
这里需要同时理解三类“分辨率”:空间分辨率描述一个像元覆盖多大地面;光谱分辨率描述传感器能区分哪些波长范围;时间分辨率描述再次观测同一地点需要多长时间。
真彩色与植被假彩色
真彩色组合为 3-2-1,即把红、绿、蓝可见光分别映射到屏幕 RGB 通道。城市大多呈灰白色,水体较暗,植被偏绿色,整体接近人眼观察结果。
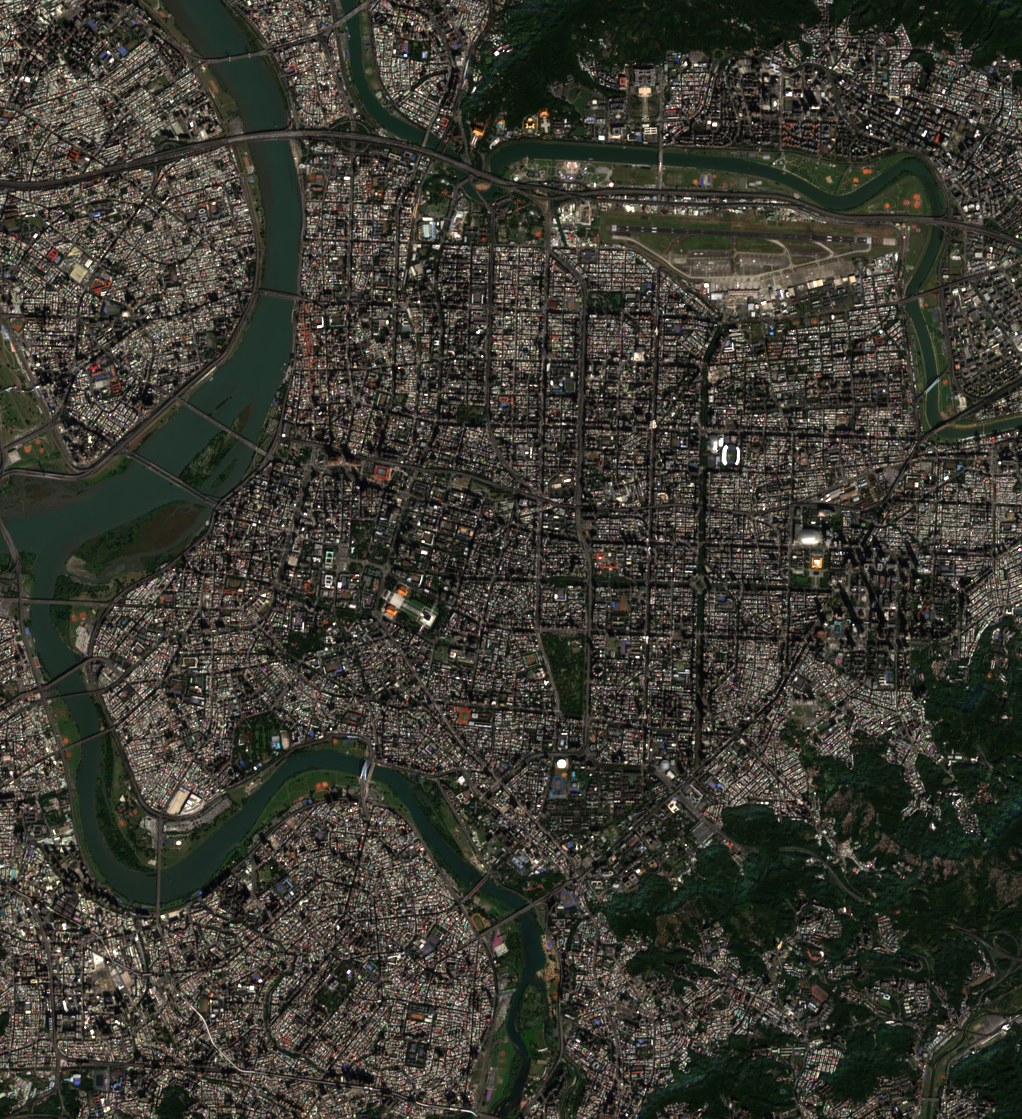
植被假彩色组合为 4-3-2,即把近红外映射到屏幕红色通道。健康植被通常具有较强的近红外反射,因此会显示为醒目的红色,城市、机场、水体与植被之间也更容易区分。
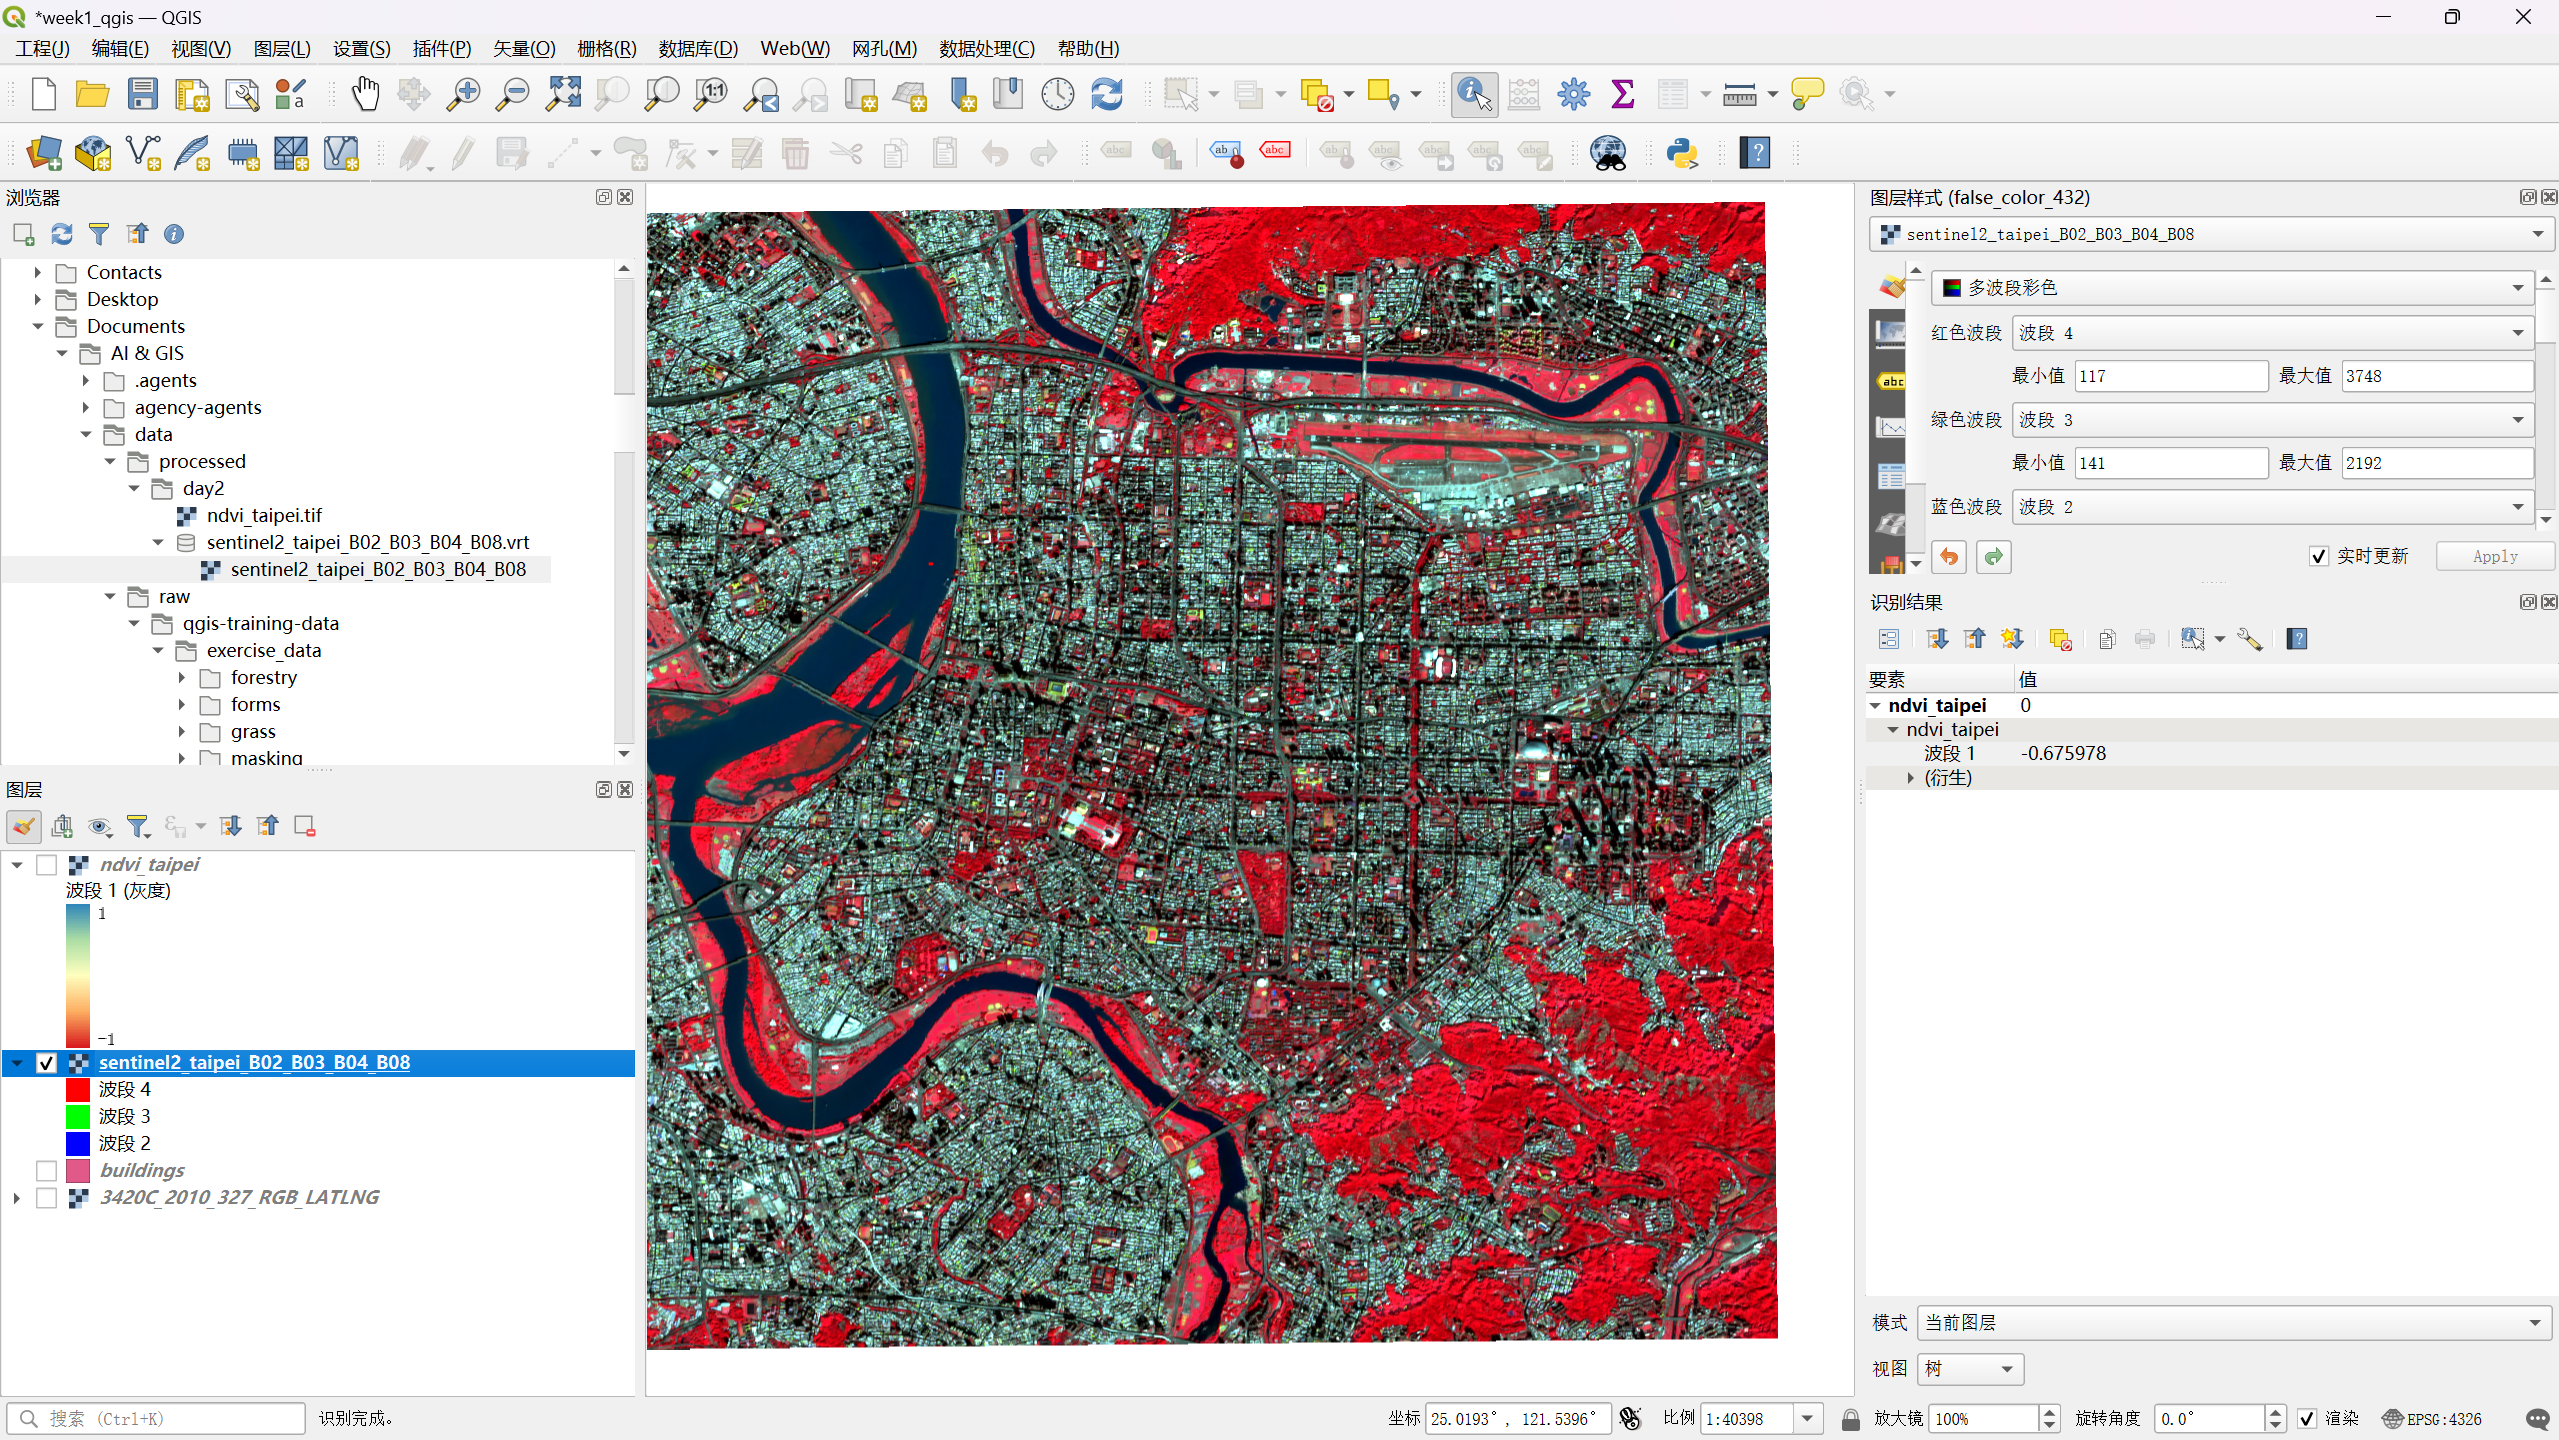
图:QGIS 中的 4-3-2 假彩色组合。右侧图层样式显示 Band 4、Band 3、Band 2 分别映射到红、绿、蓝通道;植被呈鲜红色,河流与水面偏暗。
“假彩色”并不是伪造数据。它使用的仍是真实测得的波段,只是将人眼看不见的近红外转成可见颜色,以突出特定地物。
用 NDVI 提取植被信息
NDVI 使用近红外与红光构造植被特征:
NDVI = (NIR - Red) / (NIR + Red)
     = (B08 - B04) / (B08 + B04)
在本地四波段 VRT 中,对应公式为:
(Band 4 - Band 3) / (Band 4 + Band 3)
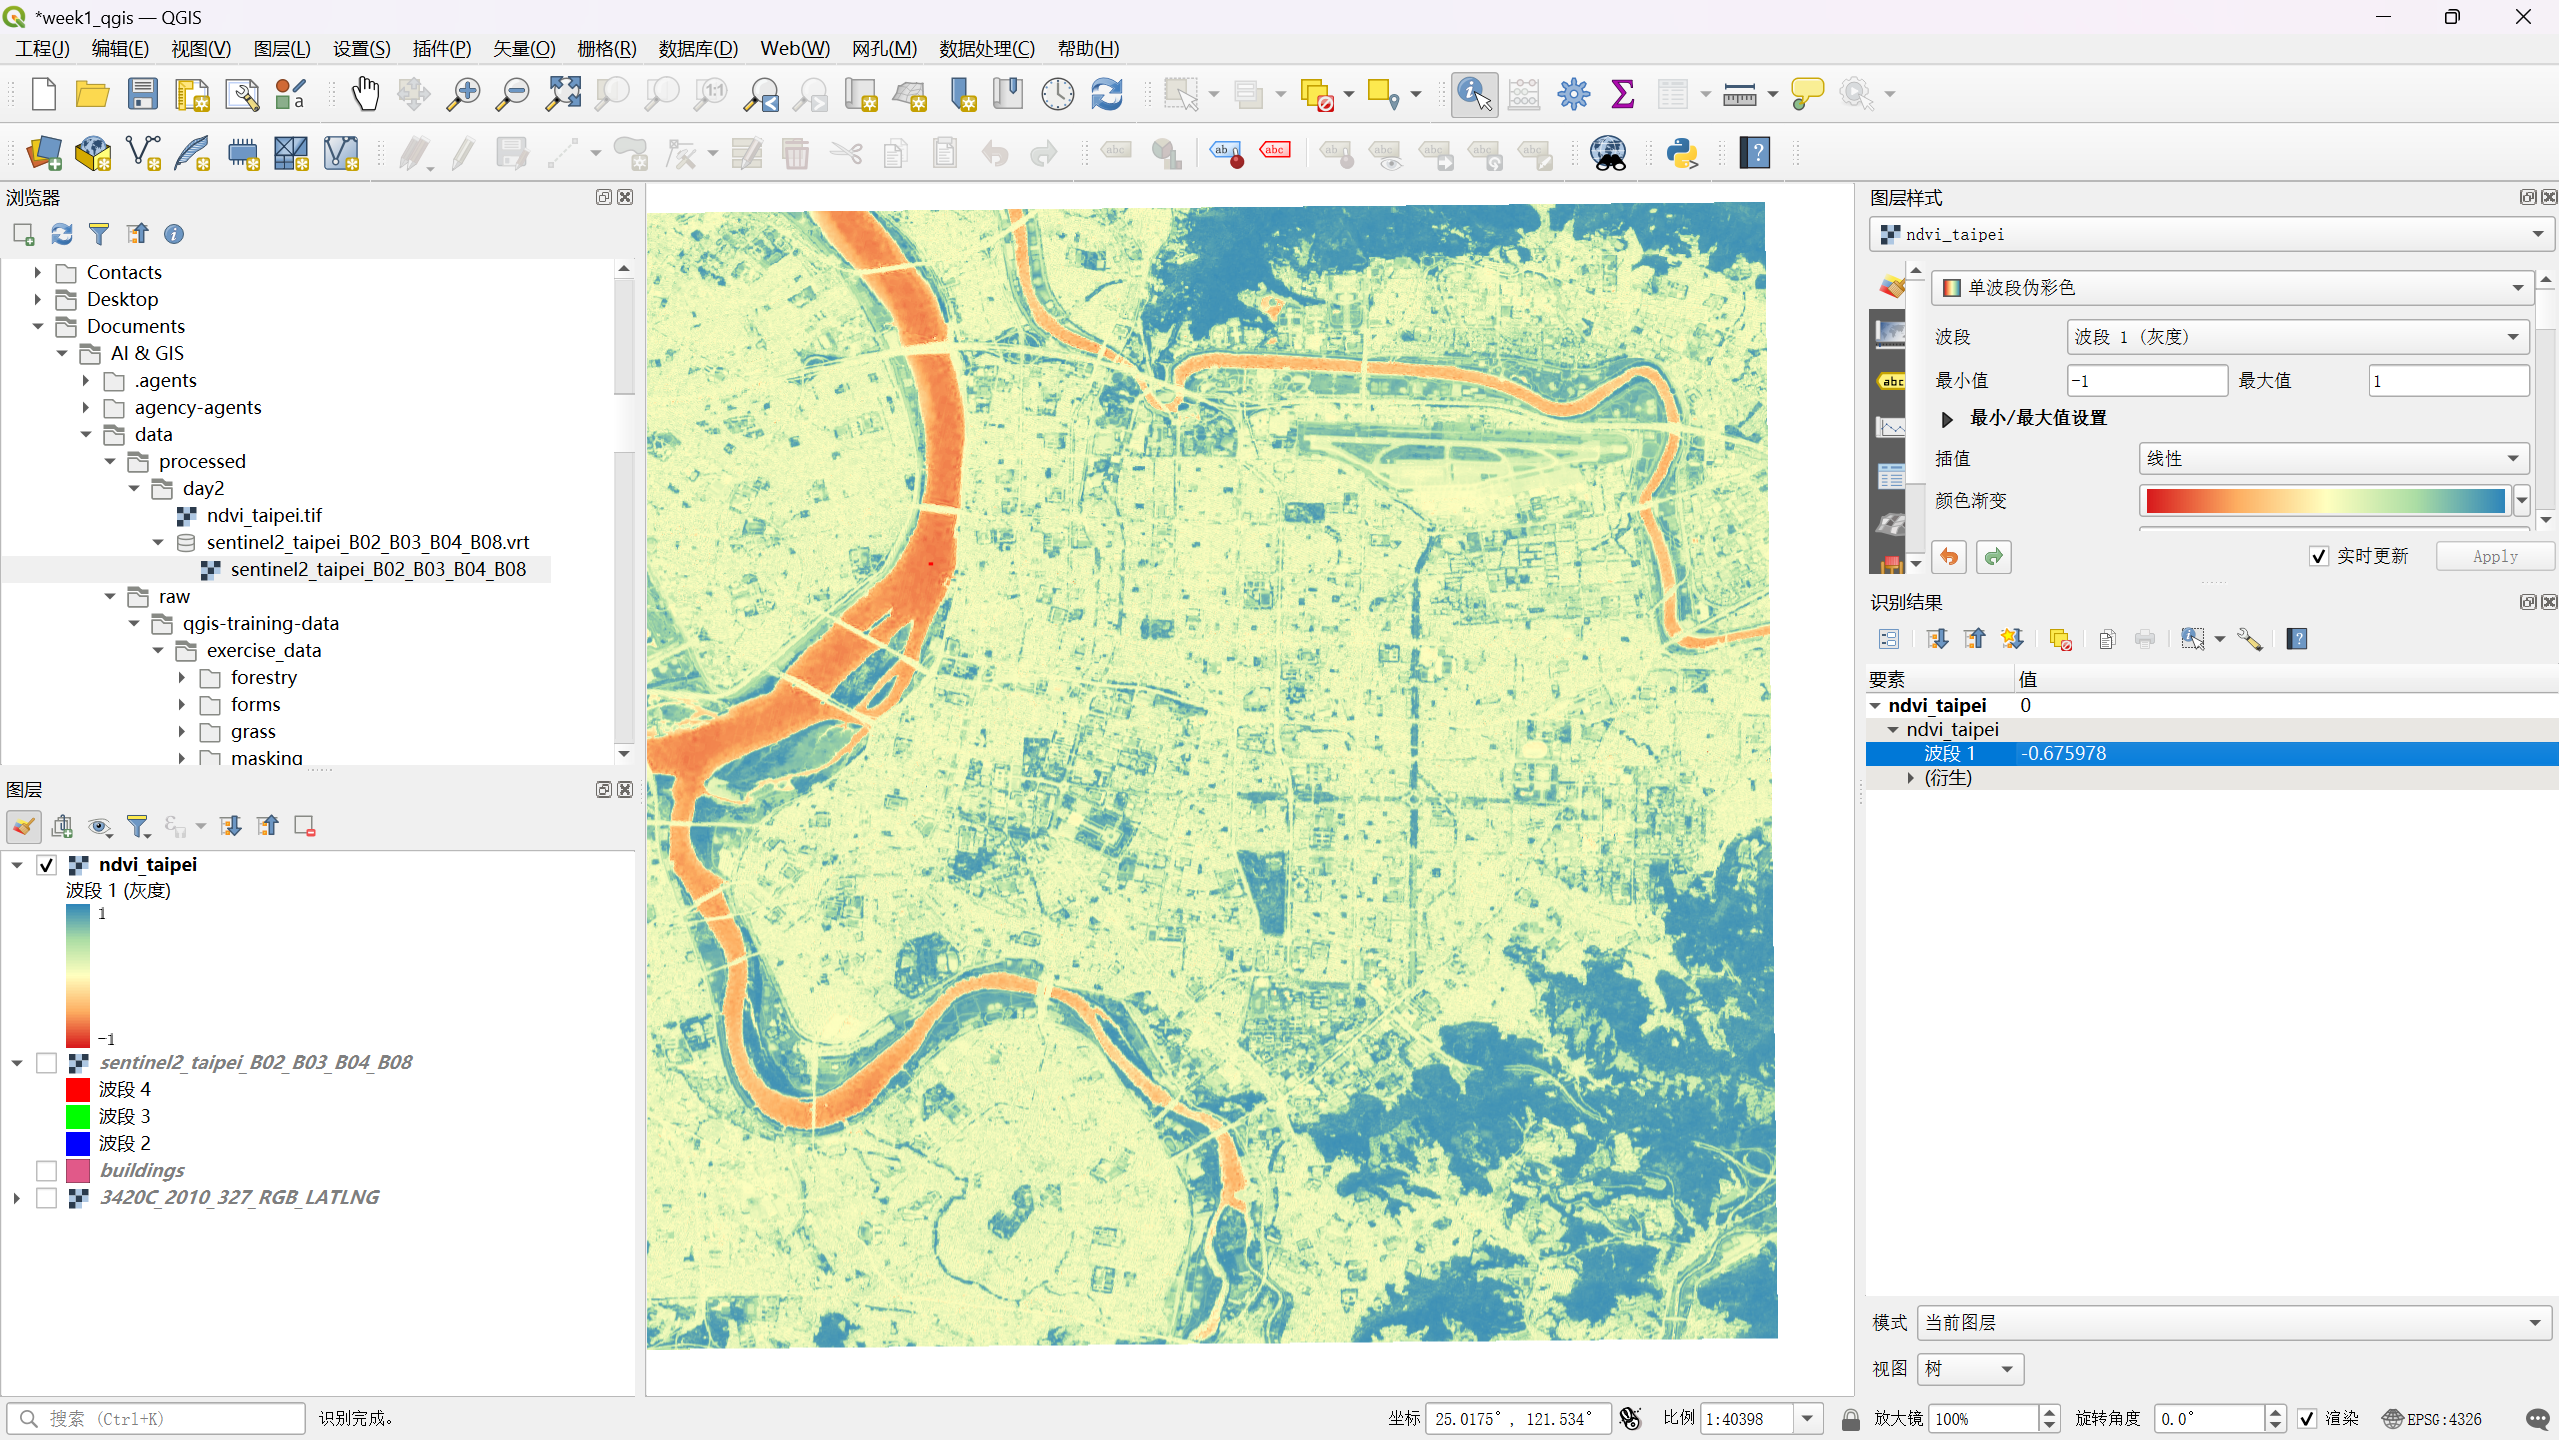
图:台北盆地 NDVI 的单波段伪彩色显示。图中抽查的河流水面像元值为 -0.675978,与水体通常呈负 NDVI 的预期一致。这里的颜色来自渲染色带,不会改变原始 NDVI 数值。
抽查结果很符合直觉:山地或公园植被约为 0.91,河流水面约为 -0.68,密集城市约为 0.30,机场跑道约为 0.13。但这些数值不能直接当作地物类别的绝对真值。一个 10 m 混合像元可能同时包含树木、草地、道路与屋顶,阴影和建筑材料也会影响结果。
NDVI 是人工设计、含义清晰且容易解释的特征;CNN 则可以从样本中学习光谱、纹理、形状和空间上下文等更复杂的特征。把 NDVI 作为额外输入可能有帮助,但如果模型已经获得红光与近红外,也可能自行学到类似关系。最终是否有效,仍应通过验证实验判断。
Day 3:把遥感影像变成数组和张量
第三天,我从 QGIS 转到 Rasterio、NumPy、Matplotlib 与 PyTorch。使用的是同一份 Sentinel-2 数据裁出的四波段 256 × 256 patch。
先读懂 shape 的语义
Rasterio 的 src.read() 返回:
image_chw.shape
# (4, 256, 256)
这个 shape 不是三个抽象数字,而是:
C = 4:B02、B03、B04、B08 四个通道;H = 256:256 行像元;W = 256:256 列像元。
shape 描述每条轴有多长,size 才是数组的总元素数;dtype 描述每个元素如何存储。三者回答的是不同问题。
切片也会改变 shape:
b02 = image_chw[0]                       # (256, 256)
center = image_chw[:, 64:192, 64:192]   # (4, 128, 128)
image_chw[0] 使用整数索引,会取出并移除 channel 轴;空间裁剪则保留四个波段,只缩小行列范围。
dtype 转换、缩放与显示拉伸不是一回事
原始影像为 UInt16,实际值范围为 28~6260。我的处理方式是先转为 Float32,再除以产品缩放因子 10000:
reflectance = image_chw.astype(np.float32) / 10000.0
转换后数值范围变为 0.0028~0.6260。这里有三件容易混淆的事:
UInt16 → Float32改变数值的表示格式;- 除以 10000 恢复反射率尺度;
- 2%~98% 百分位拉伸只改善显示效果。
它们分别作用于数据类型、物理尺度和视觉映射,不能混为同一种“归一化”。
用 mask 表达条件
在分母非零的位置安全计算 NDVI 后,我用 NDVI > 0.6 生成布尔 mask。mask 的 shape 为 (256, 256),dtype 为 bool,其中约 16.65% 的像元为 True。
这里的 True 只表示满足阈值,并不自动等于“绝对正确的植被标签”。这与 Day 2 对 NDVI 局限性的认识完全一致。
CHW、HWC 与 NCHW
同一份数据在不同工具中使用不同的轴顺序:
| 使用场景 | 常见 shape | 轴语义 |
|---|---|---|
| Rasterio / NumPy 读入 | (C,H,W) |
波段、行、列 |
| Matplotlib 彩色显示 | (H,W,C) |
行、列、RGB 通道 |
| PyTorch 批次输入 | (N,C,H,W) |
样本、通道、行、列 |
把 CHW 直接传给 plt.imshow 会得到 Invalid shape (3, 256, 256) for image data,因为 Matplotlib 要求彩色三维数组的最后一轴为 3 或 4。正确做法是明确重排轴:
rgb_chw = reflectance[[2, 1, 0]]
rgb_hwc = np.transpose(rgb_chw, (1, 2, 0))
plt.imshow(rgb_hwc)
transpose 或 permute 调整的是轴的语义顺序,不能用任意 reshape 代替。reshape 只改变如何解释连续元素,一旦使用不当,就会破坏像元位置与颜色通道之间的对应关系。
最后,将 NumPy 数组转成 PyTorch tensor,并增加 batch 轴:
tensor_chw = torch.from_numpy(reflectance)  # (4, 256, 256)
batch_nchw = tensor_chw.unsqueeze(0)        # (1, 4, 256, 256)
N=1 只表示批次中组织了一份样本。unsqueeze(0) 没有复制像元,也没有凭空创造新的地理场景。
三天学习串起来后的认识
这三天最重要的收获,不是记住了几个菜单或函数,而是建立了一条完整的数据理解路径:
地理文件与 CRS
    → 波段和像元值
    → 遥感特征(如 NDVI)
    → NumPy 数组(C,H,W)
    → 显示数组(H,W,C)
    → PyTorch 批次张量(N,C,H,W)
每一步都在回答不同问题:CRS 保证位置含义正确,空间分辨率决定可观察尺度,波段组合与指数提取可解释信息,shape 和 dtype 保证数据进入程序与模型时没有被误读。
接下来还需要继续补齐 NumPy 的 view 与 copy、裁剪后地理 transform 的更新、模型专用的 mean/std 标准化、GPU tensor 的内存关系,以及 batch size 对训练的实际影响。但至少现在,我已经能从一份真实 GeoTIFF 出发,解释它如何一步步变成模型输入。