从一条样本到最佳模型:PyTorch 二分类训练机制
从一条样本到最佳模型:PyTorch 二分类训练机制
刚开始学习 PyTorch 时,最容易遇到的问题不是某一行代码不会写,而是不清楚数据究竟怎样一步步变成一个训练好的模型:Dataset 与 DataLoader 有什么区别?为什么 features 是浮点数、labels 却是整数?backward() 和 optimizer.step() 到底谁在修改参数?accuracy 已经不变了,loss 为什么还能下降?
这篇教程用一个刻意简化的二维二分类任务,把 PyTorch 的“训练发动机”完整拆开:
数据拆分 → Tensor → Dataset → DataLoader → batch
        → model → logits → loss → backward → optimizer.step
        → validation → checkpoint → 恢复模型
数据没有地理或业务含义,每条样本只有两个数字,类别只有 0 和 1。这样做的目的,是先把注意力集中在训练机制本身。等这条链路真正贯通后,再换成图片、遥感影像或更复杂的网络,核心逻辑仍然成立。
1. 先看完整流程
下面这张图先把全文串成一条主线:800 条 train 数据负责学习参数,200 条 validation 数据在每个 epoch 后独立评估;数据先由 TensorDataset 配对,再由 DataLoader 组成 batch,送入 2 → 16 → 2 模型。训练与验证重复 20 个 epoch 后,按最低 validation loss 保存 checkpoint,最后重新加载参数并复现验证结果。
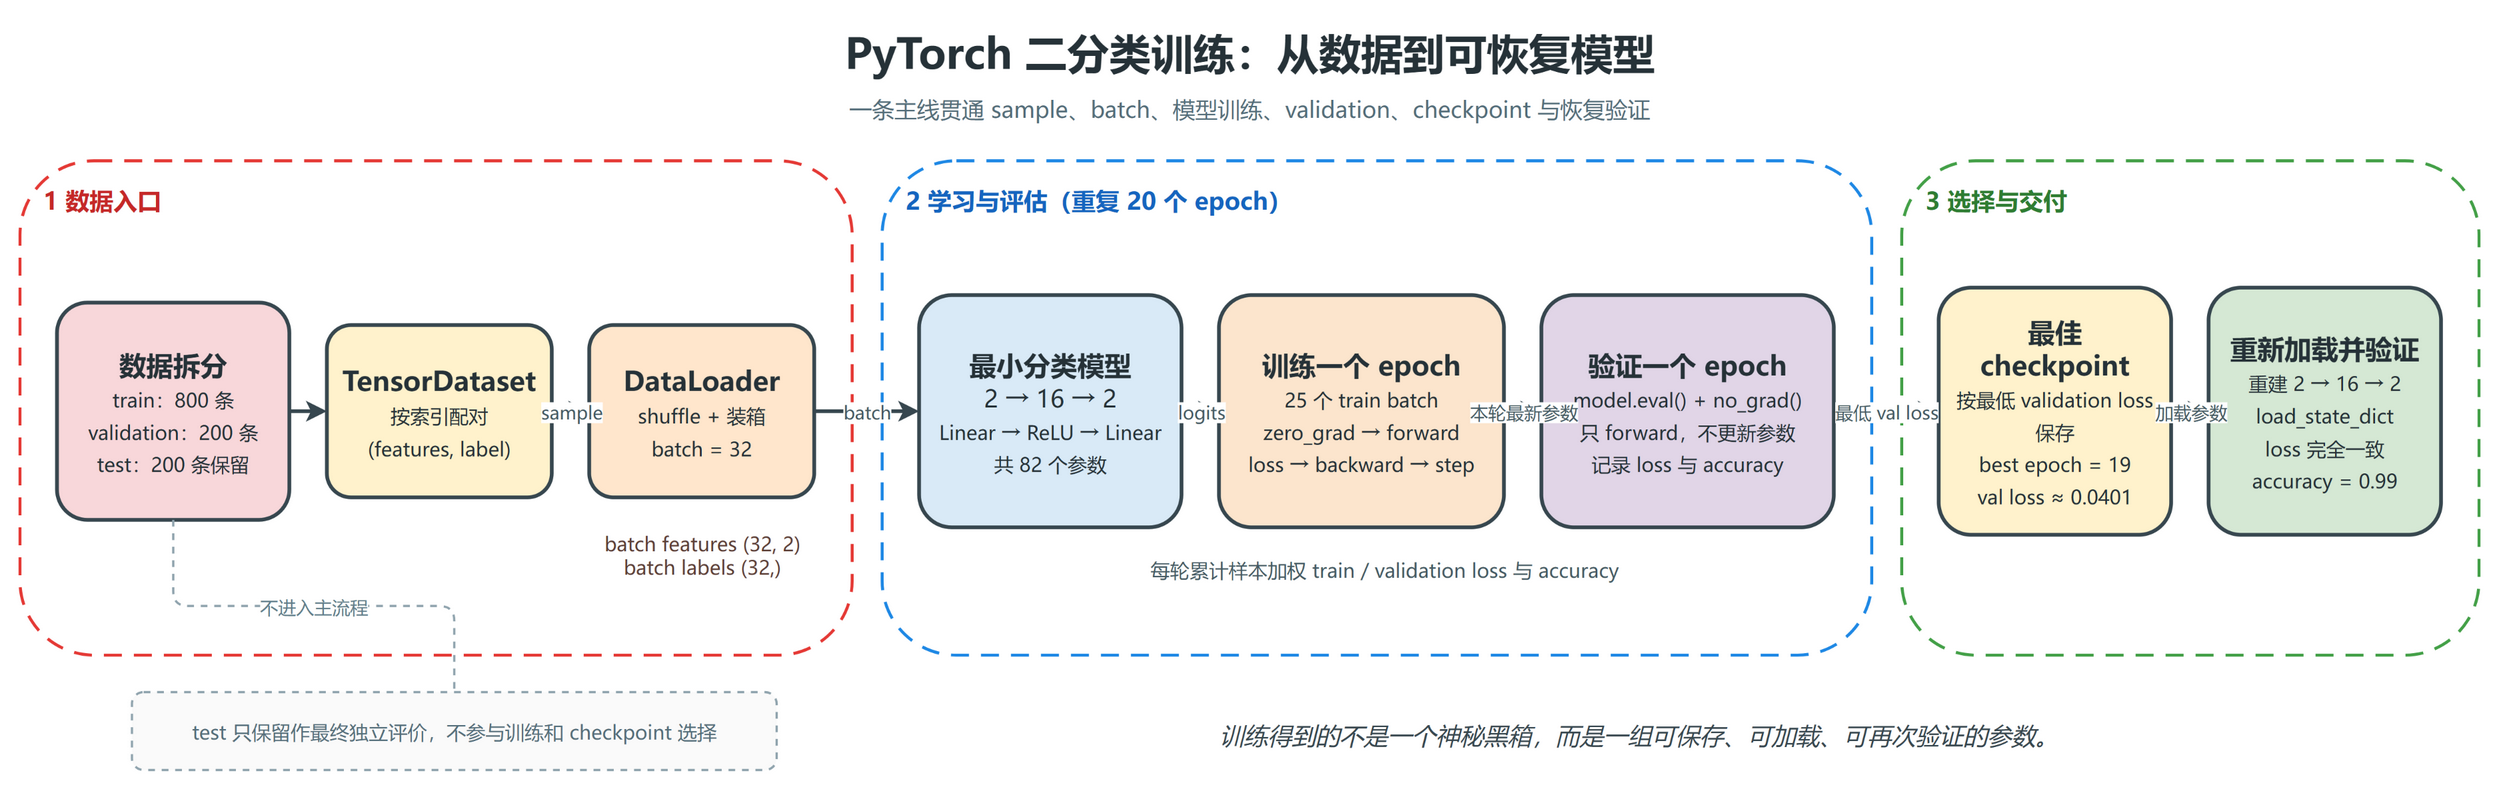
图中的 200 条 test 数据被刻意放在主流程之外:它不参与训练,也不参与 checkpoint 选择,只保留给开发完成后的最终独立评价。
2. 为什么要拆分 train、validation 和 test?
可以把机器学习实验类比成学习与考试:
| 数据集 | 类比 | 是否更新参数 | 主要用途 |
|---|---|---|---|
| train | 平时练习题 | 是 | 计算梯度并学习参数 |
| validation | 模拟考试 | 否 | 观察泛化表现、选择 checkpoint |
| test | 最终考试 | 否 | 开发结束后进行一次独立评价 |
训练集直接参与参数更新。模型读取 features,输出预测,再和 labels 比较得到 loss;backward() 计算梯度,optimizer 根据梯度修改权重。
验证集不修改参数,但会影响开发决策。例如,我们会选择 validation loss 最低的模型,因此 validation 已经间接参与了模型选择,不能再把它当作完全独立的最终测试。
测试集应留到模型结构、超参数和 checkpoint 都确定以后再使用。如果反复查看 test 结果并据此调整模型,test 也会逐渐变成另一个 validation。
3. 准备一个可重复的二维分类数据集
下面生成两个二维高斯分布:class 0 大致聚集在 (-1,-1),class 1 大致聚集在 (1,1)。两个类别各有 600 条样本,并按每类 400/100/100 拆为 train、validation 和 test。
seed=42 固定伪随机数序列,使每次重新运行都能得到相同数据。固定 seed 不代表随机性消失,而是让实验便于复现和排错。
from pathlib import Path
import numpy as np

SEED = 42
rng = np.random.default_rng(SEED)

class_zero = rng.normal(
    loc=(-1.0, -1.0),
    scale=(0.65, 0.65),
    size=(600, 2)
)

class_one = rng.normal(
    loc=(1.0, 1.0),
    scale=(0.65, 0.65),
    size=(600, 2)
)

def make_split(class_zero, class_one, start, stop, rng):
    features = np.concatenate(
        [class_zero[start:stop], class_one[start:stop]],
        axis=0
    )

    labels = np.concatenate([
        np.zeros(stop - start, dtype=np.int64),
        np.ones(stop - start, dtype=np.int64)
    ])

    order = rng.permutation(len(labels))

    return (
        features[order].astype(np.float32),
        labels[order]
    )

x_train, y_train = make_split(class_zero, class_one, 0, 400, rng)
x_val, y_val = make_split(class_zero, class_one, 400, 500, rng)
x_test, y_test = make_split(class_zero, class_one, 500, 600, rng)
这里的函数返回两个 NumPy 数组。Python 可以把二元素返回值按位置拆包:
x_train, y_train = make_split(...)
它近似等价于:
result = make_split(...)
x_train = result[0]
y_train = result[1]
这和 C 语言函数只能直接返回一个值的常见写法不同。Python 实际上先返回一个 tuple,再把其中两个对象分别绑定给左侧变量名。
检查 shape、dtype 与类别平衡
splits = {
    "train": (x_train, y_train),
    "validation": (x_val, y_val),
    "test": (x_test, y_test)
}

for name, (features, labels) in splits.items():
    print(f"\n{name}")
    print("features:", features.shape, features.dtype)
    print("labels:  ", labels.shape, labels.dtype)
    print("samples: ", len(labels))
    print("classes: ", np.bincount(labels))
输出应为:
train
features: (800, 2) float32
labels:   (800,) int64
classes:  [400 400]

validation
features: (200, 2) float32
labels:   (200,) int64
classes:  [100 100]

test
features: (200, 2) float32
labels:   (200,) int64
classes:  [100 100]
(800,2) 表示 800 条样本,每条有 2 个特征;(800,) 表示 800 个一维排列的类别答案,每条样本对应一个 label。
features 使用 float32,因为神经网络需要对它进行乘法、加法、矩阵运算和梯度计算。labels 使用 int64,因为这里的 0/1 不是参与回归计算的连续数值,而是“正确类别位于第几个位置”的索引。PyTorch 的 CrossEntropyLoss 要求类别索引使用 torch.int64,也就是 torch.long。
两个类别严格平衡,所以永远只猜一个类别,accuracy 只能达到 50%。这让后面的正确率更容易解释。若数据中 99% 都属于同一类,一个完全不学习、永远猜多数类的模型也可能得到 99% accuracy,此时只看 accuracy 会非常危险。
4. 从 NumPy 数组到 TensorDataset
PyTorch 模型主要处理 Tensor。torch.from_numpy(array) 接收 NumPy 数组,返回共享底层内存的 CPU Tensor,并保留原来的 shape 与 dtype。因为可能共享内存,就地修改其中一方时,另一方的数值也可能随之变化;它并不保证复制一份完全独立的数据。
import torch
from torch.utils.data import TensorDataset

x_train_tensor = torch.from_numpy(x_train)
y_train_tensor = torch.from_numpy(y_train)

train_dataset = TensorDataset(
    x_train_tensor,
    y_train_tensor
)
TensorDataset 可以理解为“题目与答案的配对仓库”。传给它的 Tensor 第一维长度必须一致。这里两者第一维都是 800,所以索引 i 时会同时返回:
x_train_tensor[i]:第 i 道题的两个特征
y_train_tensor[i]:第 i 道题的正确类别
取出第一条 sample:
sample_features, sample_label = train_dataset[0]

print("样本数:", len(train_dataset))
print("features:", sample_features)
print("features shape:", sample_features.shape)
print("label:", sample_label)
print("label shape:", sample_label.shape)
print("dtype:", sample_features.dtype, sample_label.dtype)
典型输出:
样本数: 800
features: tensor([-0.3332, -0.9747])
features shape: torch.Size([2])
label: tensor(0)
label shape: torch.Size([])
dtype: torch.float32 torch.int64
train_dataset[0] 返回的是一个二元素 tuple:
(features_tensor, label_tensor)
左侧的 sample_features, sample_label 再把它拆成两个变量。
一条 sample 的 features 有两个数,所以 shape 是 (2,)。单个 label 的 shape 显示为 torch.Size([]),也就是零维标量 Tensor。它不是“里面没有数据”,而是只有一个数、不再需要任何轴。可以把 (800,) 想成 800 个 label 排成一列;取出其中一个后,只剩那个数本身。
5. DataLoader 如何把 sample 组成 batch?
Dataset 负责回答“第 i 条数据是什么”,DataLoader 负责回答“按什么顺序、每次取多少条”。它像一台自动装箱机:先决定样本索引顺序,再从 Dataset 取数据,最后把多条 sample 堆叠成一个 batch。
from torch.utils.data import DataLoader

example_generator = torch.Generator().manual_seed(42)

train_loader = DataLoader(
    train_dataset,
    batch_size=32,
    shuffle=True,
    generator=example_generator
)

train_iterator = iter(train_loader)
first_batch = next(train_iterator)
batch_features, batch_labels = first_batch

print("batch features shape:", batch_features.shape)
print("batch labels shape:", batch_labels.shape)
print(batch_features[:3])
print(batch_labels[:3])
输出的关键 shape 是:
batch features shape: torch.Size([32, 2])
batch labels shape: torch.Size([32])
多条 sample 堆叠后会多出 batch 维:
一条 features:(2,) → 32 条堆叠 → (32,2)
一个 label:   ()   → 32 个排列 → (32,)
若用 C 语言数组近似类比,可以把它看成:
float batch_features[32][2];
int64_t batch_labels[32];
第一维 32 表示这一批有 32 条样本,第二维 2 才表示每条样本有两个特征。DataLoader 打乱的是样本索引,一条 features 与对应 label 会一起移动,不会因为 shuffle=True 而错配。
iter(train_loader) 创建一个带“当前读取位置”的迭代器,next(...) 从中取出下一批。迭代到末尾后,再次建立新的迭代器才能从新一轮开始。这和 C 语言中自己维护循环下标有相似之处,但 Python 迭代器把当前位置和取下一项的规则封装在对象内部。
6. 构建 2 → 16 → 2 神经网络
接下来建立一个最小的全连接分类模型:
2 个输入特征 → 16 个隐藏单元 → 2 个类别分数
注意,这三个数字描述的是每条样本在各层有多少个数值,不是 batch size。一个 batch 的完整 shape 变化是:
(32,2)
   ↓ Linear(2,16)
(32,16)
   ↓ ReLU
(32,16)
   ↓ Linear(16,2)
(32,2) logits
from torch import nn

torch.manual_seed(42)

model = nn.Sequential(
    nn.Linear(2, 16),
    nn.ReLU(),
    nn.Linear(16, 2)
)

print(model)
模型结构:
Sequential(
  (0): Linear(in_features=2, out_features=16, bias=True)
  (1): ReLU()
  (2): Linear(in_features=16, out_features=2, bias=True)
)
Linear:带权重的小计算器
第一层的每个隐藏单元都读取两个输入,进行加权求和并加上 bias:
h = x1 × w1 + x2 × w2 + b
16 个隐藏单元各有自己的权重和 bias,因此会产生 16 个中间值。用矩阵写法表示,Linear(2,16) 的计算是:
Y = XWᵀ + b
输入 X 是 (32,2),weight 是 (16,2),输出 Y 是 (32,16)。PyTorch 自动让同一个 bias 向量作用于 batch 中所有样本。
ReLU:加入非线性的开关
ReLU 的规则是:
ReLU(x) = max(0, x)
负数变为 0,正数保持不变。它没有需要学习的参数,像固定规则的开关。若多层网络之间完全没有非线性激活函数,多个 Linear 叠加后在数学上仍可合并成一个 Linear,模型表达能力不会真正增加。
Sequential:计算流水线
nn.Sequential 按声明顺序把前一层输出交给下一层。它类似一条流水线,但流水线中保存的是 Python 模块对象及其参数,而不是把代码文本简单拼接起来。
执行一次 forward:
logits = model(batch_features)

print("输入 shape:", batch_features.shape)
print("logits shape:", logits.shape)
print(logits[:3])
model(batch_features) 只用当前参数进行前向计算,不会自动修改权重。输出 (32,2) 表示 32 条样本各得到两个类别的原始分数。
7. Logits、loss 和 accuracy 分别在衡量什么?
Logits 是原始分数,不是概率
logits 可以为正、为负,也不要求一行相加等于 1。例如:
[-0.08, -0.64]
虽然两个数都为负,但第 0 个分数更大,所以预测类别是 0。取得分最大位置的代码是:
predictions = logits.argmax(dim=1)
dim=1 表示沿每一行的“类别轴”寻找最大值位置。输入 (32,2),输出 (32,),刚好与 labels 对齐。
CrossEntropyLoss 接收什么?
loss_fn = nn.CrossEntropyLoss()
loss = loss_fn(logits, batch_labels)
输入要求:
- logits:浮点 Tensor,shape 为
(N,C); - labels:整数类别索引,shape 为
(N,),dtype 为int64; - 输出:零维标量 loss Tensor。
CrossEntropyLoss 内部已经完成适合数值稳定性的 log-softmax 与负对数似然计算,因此模型末尾不要为了它手动添加 softmax。
loss 是训练真正优化的连续目标。它不仅关心是否答对,还关心模型对正确答案给出了多强的相对支持。答对但非常犹豫,loss 仍可能较高;答对且对正确类别明显更有把握,loss 会更低。
Accuracy 只计算答对比例
correct_count = (predictions == batch_labels).sum()
accuracy = correct_count.float() / len(batch_labels)
如果 32 条中答对 18 条:
accuracy = 18 / 32 = 0.5625 = 56.25%
accuracy 是离散指标。只要得分最高的类别位置没有改变,即使两个 logits 之间的差距变大,accuracy 也不会变化;但 loss 仍可能继续下降。这就是训练后期常见的“accuracy 进入平台期,loss 仍缓慢改善”。
模型为什么有 82 个参数?
parameter_count = sum(
    parameter.numel()
    for parameter in model.parameters()
)

print(parameter_count)  # 82
逐层计算:
Linear(2,16):2×16 个 weight + 16 个 bias = 48
Linear(16,2):16×2 个 weight + 2 个 bias = 34
ReLU:0
总数:48 + 34 = 82
8. 一次训练迭代到底发生了什么?
一批数据的训练顺序是:
optimizer.zero_grad()
logits = model(features)
loss = loss_fn(logits, labels)
loss.backward()
optimizer.step()
可以把它理解为“清空旧记录 → 答题 → 批改 → 追责 → 修改”:
| 顺序 | 操作 | 发生的事 | 是否修改参数 |
|---|---|---|---|
| 1 | zero_grad() |
清空参数 .grad 中残留的梯度 |
否 |
| 2 | forward | 用当前参数算出 logits,并建立计算图 | 否 |
| 3 | loss | 把整批预测与答案压缩为标量损失 | 否 |
| 4 | backward() |
沿计算图反向求每个参数的梯度,写入 .grad |
否 |
| 5 | step() |
optimizer 读取梯度与学习率,更新参数 | 是 |
为什么先 zero_grad?
PyTorch 默认把新梯度累加到已有 .grad,而不是自动覆盖。这对某些需要梯度累积的训练方法很有用,但普通训练若不清空,当前 batch 与此前 batch 的梯度会意外叠加。
zero_grad() 清的是梯度缓存,不会清空模型权重,也不会删除刚才的数据。
backward 计算的梯度是什么?
对某个参数 w 而言,梯度可写成:
∂loss / ∂w
它描述在当前参数附近,w 发生微小变化时 loss 如何变化。梯度指向 loss 局部上升最快的方向,因此 SGD 使用减号向反方向移动:
新参数 = 旧参数 - learning_rate × gradient
gradient 不是直接告诉模型“标准答案参数是多少”,也不是穷举所有参数组合。它只提供当前位置附近的局部坡度。可以把模型想成站在山坡上的人:loss 是当前海拔,梯度描述最陡的上坡方向,SGD 则朝相反方向迈一步。
optimizer.step 才真正修改参数
optimizer = torch.optim.SGD(
    model.parameters(),
    lr=0.1
)
model.parameters() 把可训练参数交给 optimizer 管理;lr=0.1 是学习率,决定每次沿梯度方向走多远。步子过小会学习缓慢,过大则可能越过低点、震荡甚至发散。
下面直接比较更新前后的第一层权重:
weight_before = model[0].weight.detach().clone()

optimizer.zero_grad()
logits = model(batch_features)
loss = loss_fn(logits, batch_labels)
loss.backward()

print("weight shape:", model[0].weight.shape)
print("gradient shape:", model[0].weight.grad.shape)

optimizer.step()

weight_after = model[0].weight.detach().clone()
maximum_change = (weight_after - weight_before).abs().max()

print("最大参数变化:", maximum_change.item())
weight 和 gradient 都是 (16,2),表示第一层每个 weight 都有一个对应梯度。detach() 把观察值从自动求导关系中分离,clone() 再复制一份独立快照。若不复制,所谓“更新前变量”可能仍引用已被 optimizer 就地修改的同一份参数内存。
在本次实验中,一次更新后同一 batch 的 loss 从约 0.6453 降到 0.5507。这说明这次更新在当前 batch 上有效,但不能推出任何模型、任何 batch 和任何学习率下,单步 loss 都必然下降。
9. 从一次更新扩展到完整训练
一个 batch 只覆盖部分训练样本。epoch 表示完整遍历一次训练集。这里训练集有 800 条数据,batch_size=32,所以每个 epoch 有:
800 / 32 = 25 个 batch
先建立验证集与两个 DataLoader,再重新初始化正式模型,避免前面的机械演示污染正式实验:
x_val_tensor = torch.from_numpy(x_val)
y_val_tensor = torch.from_numpy(y_val)
val_dataset = TensorDataset(x_val_tensor, y_val_tensor)

batch_size = 32
learning_rate = 0.1
num_epochs = 20
data_seed = 42

torch.manual_seed(data_seed)
shuffle_generator = torch.Generator().manual_seed(data_seed)

train_loader = DataLoader(
    train_dataset,
    batch_size=batch_size,
    shuffle=True,
    generator=shuffle_generator
)

val_loader = DataLoader(
    val_dataset,
    batch_size=batch_size,
    shuffle=False
)

model = nn.Sequential(
    nn.Linear(2, 16),
    nn.ReLU(),
    nn.Linear(16, 2)
)

loss_fn = nn.CrossEntropyLoss()
optimizer = torch.optim.SGD(
    model.parameters(),
    lr=learning_rate
)
训练集设置 shuffle=True,避免每个 epoch 总以同样的局部顺序形成 batch。验证集不需要通过打乱来帮助优化,因此保持固定顺序更利于重复检查。
10. 为什么 epoch loss 要按样本数加权?
CrossEntropyLoss 默认返回当前 batch 的平均 loss。若数据量不能被 batch size 整除,最后一个 batch 会更小。直接平均“各 batch 的平均 loss”,会让小 batch 和大 batch 获得相同权重。
正确思路是先恢复每批总 loss:
batch 总 loss = batch 平均 loss × batch 样本数
累加全部 batch 后再除以总样本数:
epoch loss = 所有样本 loss 总和 / 总样本数
对应代码:
batch_sample_count = labels.size(0)
loss_sum += loss.item() * batch_sample_count
sample_count += batch_sample_count

epoch_loss = loss_sum / sample_count
accuracy 同样应累计答对总数,最后除以样本总数,而不是只记录最后一个 batch 的 accuracy。
11. 20 个 epoch 的训练、验证与 checkpoint
history = {
    "train_loss": [],
    "train_accuracy": [],
    "val_loss": [],
    "val_accuracy": []
}

best_val_loss = float("inf")
checkpoint_path = Path("best_toy_classifier.pt")

for epoch in range(num_epochs):
    # ---------- Training ----------
    model.train()

    train_loss_sum = 0.0
    train_correct = 0
    train_sample_count = 0

    for features, labels in train_loader:
        optimizer.zero_grad()

        logits = model(features)
        loss = loss_fn(logits, labels)

        loss.backward()
        optimizer.step()

        batch_count = labels.size(0)
        train_loss_sum += loss.item() * batch_count
        train_correct += (
            logits.argmax(dim=1) == labels
        ).sum().item()
        train_sample_count += batch_count

    train_loss = train_loss_sum / train_sample_count
    train_accuracy = train_correct / train_sample_count

    # ---------- Validation ----------
    model.eval()

    val_loss_sum = 0.0
    val_correct = 0
    val_sample_count = 0

    with torch.no_grad():
        for features, labels in val_loader:
            logits = model(features)
            loss = loss_fn(logits, labels)

            batch_count = labels.size(0)
            val_loss_sum += loss.item() * batch_count
            val_correct += (
                logits.argmax(dim=1) == labels
            ).sum().item()
            val_sample_count += batch_count

    val_loss = val_loss_sum / val_sample_count
    val_accuracy = val_correct / val_sample_count

    history["train_loss"].append(train_loss)
    history["train_accuracy"].append(train_accuracy)
    history["val_loss"].append(val_loss)
    history["val_accuracy"].append(val_accuracy)

    if val_loss < best_val_loss:
        best_val_loss = val_loss

        torch.save(
            {
                "epoch": epoch + 1,
                "model_state_dict": model.state_dict(),
                "optimizer_state_dict": optimizer.state_dict(),
                "validation_loss": val_loss,
                "data_seed": data_seed,
                "batch_size": batch_size,
                "learning_rate": learning_rate
            },
            checkpoint_path
        )

    print(
        f"Epoch {epoch + 1:02d}/{num_epochs} | "
        f"train loss {train_loss:.4f}, acc {train_accuracy:.4f} | "
        f"val loss {val_loss:.4f}, acc {val_accuracy:.4f}"
    )
model.train()、model.eval() 与 no_grad() 的区别
这三个 API 经常一起出现,但职责不同:
model.train():把模型切换到训练模式;model.eval():把模型切换到评估模式;torch.no_grad():在代码块中关闭梯度记录,减少验证时的内存和计算开销。
train() 与 eval() 会影响 Dropout、BatchNorm 等层的行为,但不会自动开启或关闭梯度,也不会自动运行训练循环。本文的小模型没有 Dropout 和 BatchNorm,因此两种模式下 forward 数值规则相同;仍保留标准写法,是为了代码能自然迁移到更复杂模型。
验证阶段不调用 backward() 和 optimizer.step(),所以 validation 不会修改参数。no_grad() 也不会永久改变模型,离开 with 代码块后,正常的梯度记录规则会恢复。
为什么按最低 validation loss 保存?
最后一个 epoch 不一定是泛化表现最好的 epoch。每轮 validation 后,只在 loss 创下新低时保存:
if val_loss < best_val_loss:
    torch.save(...)
这里使用严格小于号。即使两个 loss 打印到四位小数都为 0.0401,完整浮点值仍可能不同;也可能后一轮没有严格更低,因此 checkpoint 保留在更早的 epoch。
checkpoint 不只保存权重,还记录 optimizer 状态、epoch 与关键配置。model_state_dict 保存模型参数,optimizer_state_dict 保存继续训练所需的优化器状态。对于带动量的优化器,optimizer state 尤其重要。
12. 阅读训练结果
本次 20 个 epoch 的关键结果如下:
Epoch 01 | train loss 0.2545, acc 0.9500 | val loss 0.1101, acc 0.9850
Epoch 02 | train loss 0.0996, acc 0.9788 | val loss 0.0698, acc 0.9850
Epoch 04 | train loss 0.0681, acc 0.9775 | val loss 0.0510, acc 0.9900
...
Epoch 19 | train loss 0.0561, acc 0.9800 | val loss 0.0401, acc 0.9900
Epoch 20 | train loss 0.0560, acc 0.9800 | val loss 0.0401, acc 0.9900
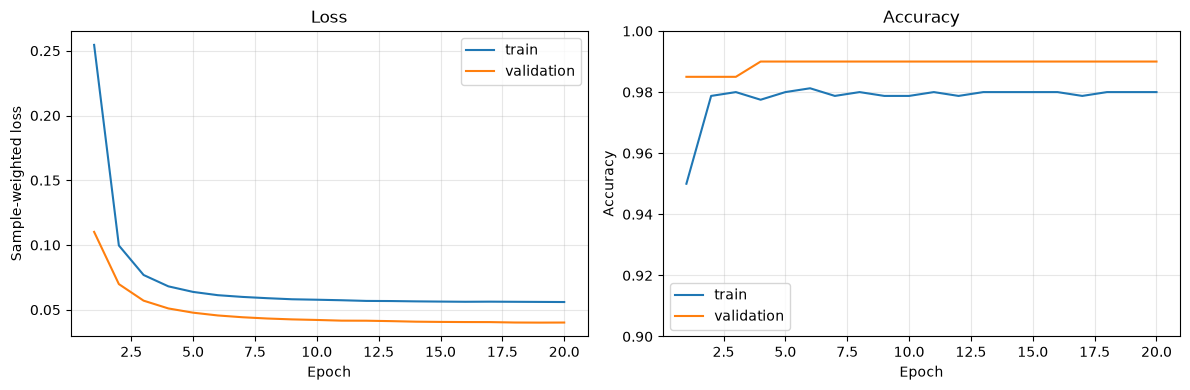
左图中,loss 在前 2~4 轮下降最快,随后下降速度逐渐放缓。这符合梯度下降的直觉:模型初始参数较差,容易找到能显著降低错误的方向;进入较低 loss 区域后,剩余改进更细小,下降曲线逐渐变平。
右图中,train accuracy 在第 2 轮左右已稳定在约 98%,validation accuracy 从第 4 轮起稳定在 99%。accuracy 很早不变,但 loss 仍缓慢下降,说明许多样本的最终类别没有改变,模型对正确类别的相对支持却还在调整。
validation 指标略好于 train 并不一定异常。本例中,train 指标是在一个 epoch 内边更新边累计的,包含该轮前半段较弱模型的结果;validation 则在该轮训练结束后,用最新参数统一计算。此外,200 条 validation 样本也可能刚好比训练集略容易。
典型过拟合常表现为 train loss 持续下降,而 validation loss 开始上升,两条曲线逐渐分离。本次 20 个 epoch 中两者都在下降,因此没有看到明显的典型过拟合信号。但这只能描述当前数据、模型与训练区间,不能证明模型永远不会过拟合,也不能证明已经找到全局最优解。
validation accuracy 0.99 表示 200 条样本中答对 198 条。它明显高于平衡二分类中永远猜同一类的 50% 基线,但在真实任务中仍应结合类别不平衡、Precision、Recall、F1、混淆矩阵以及错误样本分布共同评价。
13. 读取并恢复最佳 checkpoint
先读取 checkpoint:
checkpoint = torch.load(
    checkpoint_path,
    map_location="cpu",
    weights_only=True
)

print(checkpoint.keys())
print("best epoch:", checkpoint["epoch"])
print("best validation loss:", checkpoint["validation_loss"])
本次保存结果为:
best epoch: 19
best validation loss: 0.040070287846028806
state_dict 只保存参数映射,不保存完整的 Python 模型结构。因此恢复前要先创建相同结构:
restored_model = nn.Sequential(
    nn.Linear(2, 16),
    nn.ReLU(),
    nn.Linear(16, 2)
)

load_result = restored_model.load_state_dict(
    checkpoint["model_state_dict"]
)

print(load_result)
输出 <All keys matched successfully> 表示参数名称和 shape 全部匹配。若网络结构改变,例如把隐藏单元从 16 改为 32,旧参数就无法直接按原结构加载。
最后重新计算 validation:
restored_model.eval()

restored_loss_sum = 0.0
restored_correct = 0
restored_count = 0

with torch.no_grad():
    for features, labels in val_loader:
        logits = restored_model(features)
        loss = loss_fn(logits, labels)

        batch_count = labels.size(0)
        restored_loss_sum += loss.item() * batch_count
        restored_correct += (
            logits.argmax(dim=1) == labels
        ).sum().item()
        restored_count += batch_count

restored_val_loss = restored_loss_sum / restored_count
restored_val_accuracy = restored_correct / restored_count

print("保存的 validation loss:", checkpoint["validation_loss"])
print("恢复后 validation loss:", restored_val_loss)
print("恢复后 validation accuracy:", restored_val_accuracy)
结果为:
保存的 validation loss: 0.040070287846028806
恢复后 validation loss: 0.040070287846028806
恢复后 validation accuracy: 0.99
恢复后的 loss 与保存值完全一致,说明 checkpoint 不只是“文件存在”,而是真的能还原最佳模型。
14. 把整条训练链路串起来
现在可以用一条完整的数据生命周期理解 PyTorch 训练:
NumPy 数组
  ↓ torch.from_numpy
Tensor
  ↓ TensorDataset 按索引配对
sample:(features, label)
  ↓ DataLoader 打乱并堆叠
batch:(32,2) 与 (32,)
  ↓ model forward
logits:(32,2)
  ↓ CrossEntropyLoss
标量 loss
  ↓ backward
每个参数的 .grad
  ↓ optimizer.step
更新后的 weights / biases
  ↓ 多个 batch、多个 epoch
训练指标与 validation 指标
  ↓ 最低 validation loss
最佳 checkpoint
  ↓ 重建结构并 load_state_dict
可恢复的模型
下面再用一张生命周期图,把数据形态、计算步骤、参数变化和模型恢复放到同一幅图中。左侧是五个连续阶段,右侧专门标出最容易混淆的职责边界。
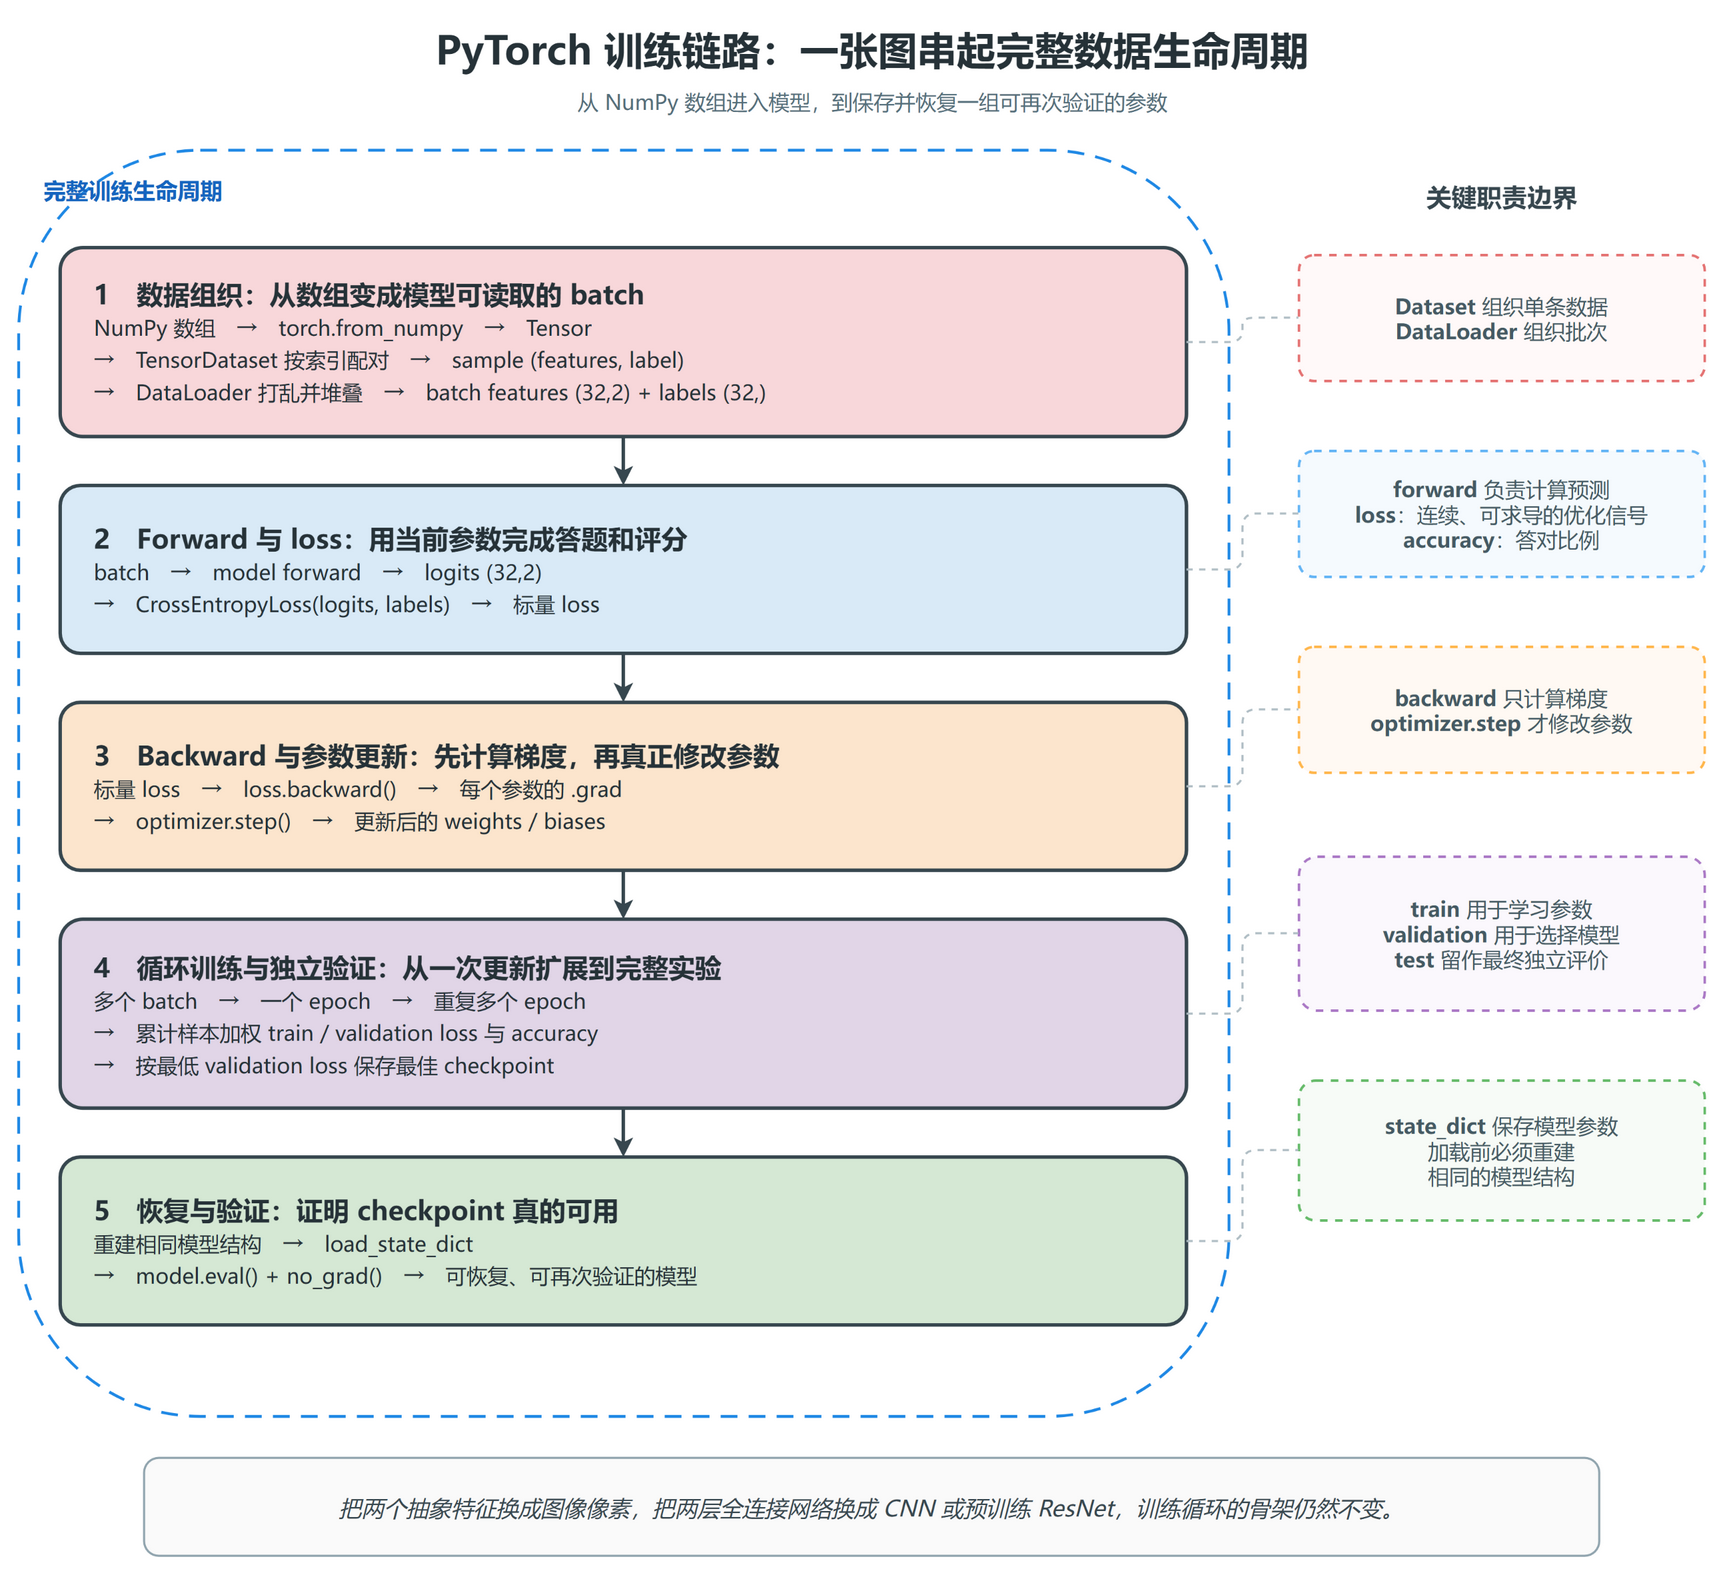
其中最关键的边界是:Dataset 组织单条数据,DataLoader 组织批次;forward 负责计算预测,backward 负责计算梯度,optimizer 才负责修改参数;train 用于学习,validation 用于选择,test 留作最终独立评价;accuracy 衡量答对比例,loss 提供更细腻、可求导的优化信号。
掌握这套最小机制后,把两个抽象特征换成图像像素,把两层全连接网络换成 CNN 或预训练 ResNet,训练循环的骨架仍然是同一套逻辑。